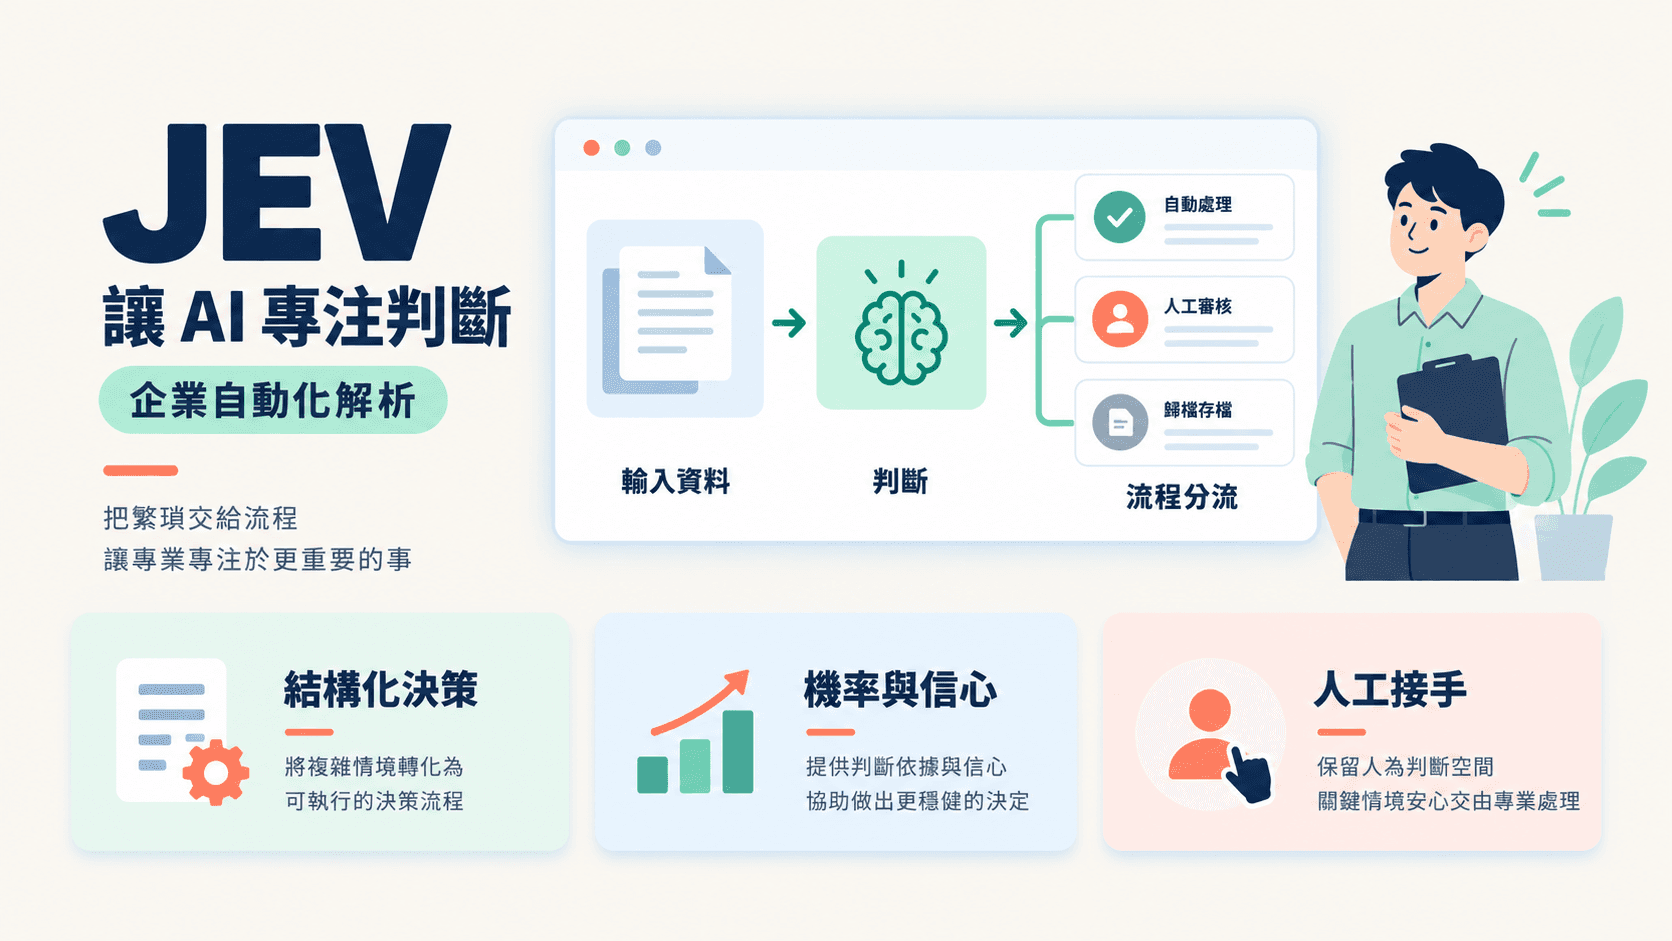
Jev 是 TypeSafe 的第一個 System One model:它接收 state 與預先定義的 typed questions,不生成自由文字,而直接回傳程式可使用的 typed values 與機率。結論先說,Jev 的定位是企業 workflow 裡的決策函式,不是聊天模型的全面替代品;它能把輸出範圍與不確定性變成程式可處理的訊號,但分類、評分仍可能錯,必須配合資料驗證、風險規則與人工覆核。
TypeSafe 在 2026-09-14 的官方文章中宣布 Jev 開放 early access,並將它稱為第一個 System One model。TypeSafe AI 官方公告,2026-09-14 本文是技術研析,不把官方展示或 workflow eval 直接當成企業保證;重點是先理解它能解決哪一段問題,再決定是否值得測試。
Jev 解決的是哪一段問題?
企業把 AI 接進流程時,常見需求不是「再寫一段漂亮文字」,而是回答幾個會影響下一步的問題:這件客服案件要分給哪個佇列?這份文件屬於哪一類?這個輸出是否需要人工覆核?這個案件的風險分數落在哪個等級?
既有 LLM 也能透過 structured outputs 回傳 JSON 或其他結構,但通常仍是以文字生成為核心,再由應用程式解析與驗證。Jev 的產品定位則相反:先定義問題型別與可能的結果,再讓模型針對 state 做決策。它不生成自由文字,所以不能把它描述成「任意新字串擷取器」;要輸出什麼,必須先在 schema、選項或評分規格中定義。
這也是為什麼 Jev 不取代 LLM。需要摘要、客服回覆草稿、長文或程式碼時,LLM 仍有價值;需要把判斷接到 if、route、sort 或權限流程時,System One model 可能是另一個更直接的元件。企業可以讓 LLM 負責理解與生成,讓 Jev 負責範圍明確的判斷,再由一般程式碼決定是否執行。
從 state 到決策:一次呼叫發生什麼
TypeSafe 文件把 Jev 的基本介面描述成「送入 state 與 typed questions,取得結構化答案」。可以把資料路徑簡化成:
state + typed questions
        → parallel sampler
        → typed values + probability distributions
同一次 API call 可以混合 Choice、Score 與 Noul;每個問題會對同一份 state 平行且獨立評估,不是逐 token 生成一個答案再把下一題接在前一題後面。問題數增加時,官方文件稱回應時間只會小幅增加;但企業仍應以自己的網路、資料查詢與後續程式碼量測完整延遲。TypeSafe Docs〈Introduction〉,查閱 2026-09-16
這個設計的實務含義是:模型回傳判斷,workflow 程式保留組合邏輯。例如,先分別問「案件類型」「資料是否完整」「是否需要人工覆核」,再由程式依企業規則組合結果。不要把多個條件塞成一句含糊的大問題,也不要讓模型自行決定付款、退款或權限提升。
Choice、Score、Noul 與 confidence 的差異
TypeSafe 目前文件列出三種 AI primitive。它們不是三種不同的聊天模式,而是三種不同的問題契約:
| 問題類型 | 適合問什麼 | 回傳與限制 |
|---|---|---|
| Choice | 從預先定義的選項中選一項 | choice、probabilities、confidence |
| Score | 依既定 rubric 評分或分級 | score、probabilities、confidence |
| Noul | 某個明確敘述是否為真 | noul,數值範圍 0–1;沒有 confidence |
Confidence 文件特別說明,Choice 的 probabilities 是各選項的分布,Score 的 probabilities 是各分數層級的分布;confidence 是由這個分布計算出的單一數值,方便程式設門檻。分布集中時通常代表判斷較明確,分散時代表選項或等級較接近。TypeSafe Docs〈Confidence〉,查閱 2026-09-16
這個 confidence 不是「這一筆答案有 87% 正確」的承諾,也不等於經過企業資料驗證的準確率。真正要看的,是在你的資料上,高 confidence 是否較常對應人工確認的正確結果;若資料分布改變,原本的門檻也可能失效。Noul 只有 0–1 的值,不能因為數字看起來精確,就替它加上一個不存在的 confidence 欄位。
RLCD、平行取樣與官方數字怎麼讀
TypeSafe 將訓練方法稱為 Reinforcement Learning for Calibrated Decisions(RLCD),目標是讓模型產生適合程式消費的決策與校準機率。它搭配 parallel sampler,一次平行產生問題結果;這和傳統 LLM 逐 token、前後相依的生成方式不同。TypeSafe AI 官方公告,2026-09-14
官方文章提到的 70–500ms,是在美西筆電與美西服務測得的 end-to-end response time,不是台灣使用者的 SLA。台灣企業還要加上跨區網路、認證、資料查詢、規則判斷、人工交接與寫回系統的時間,不能直接拿這個區間當承諾。
首頁所引用的 193.6x faster 與 444.6x cheaper,來自 TypeSafe 自家的 workflow eval 高端結果,不是所有任務都能得到的普遍倍率。該評估以其他模型的平均預測作為 reference,並非獨立人工真值標記;比較中的 LLM 還使用要求輸出機率的 System One wrapper,這會影響延遲與成本。因此,選型時應重跑自己的任務、人工標記與完整工作流成本,不必為了對應宣傳數字硬塞價格假設。
「不能幻覺」到底保證了什麼?
這句話最精確的理解是 schema 與型別約束:可能的輸出結構先被定義,模型不會回傳不符合型別的值。對需要讓程式安全解析的流程,這能消除一類 type error;但它不會自動消除語意錯誤。
Jev 仍可能把客服案件選到錯誤佇列、對文件評錯分、在 state 資訊不足時做出不理想判斷,或被惡意輸入誘導。它也不代表校準永遠不漂移,更不代表所有預先定義的選項都涵蓋真實世界。企業要把 unknown、需要人工確認與資料不足的路徑寫進 schema 和 workflow,而不是把「不能幻覺」改寫成「答案永遠正確」。
企業可先評估的三種場景
以下是導入設計建議,不是 YOTRON 的實測案例。
- 客服分流:用 Choice 從產品問題、帳務、售後或其他既有佇列中選擇,另設 unknown/需要人工的選項。Jev 可協助決定路由,回覆文字仍可由 LLM 產生草稿並交給客服確認。
- 文件分類:先定義版本、部門或案件類別,再用 Choice 或 Score 判斷。若企業新增分類,應更新 schema 與測試,不把它當成模型可以任意產生新標籤的證明。
- 輔助護欄:用 Noul 檢查明確敘述,或用 Choice 將輸出送往放行、補資料、人工檢查等路徑。護欄只是 workflow 的一層,仍要配合權限、紀錄與可回滾設計。
付款、退款、對外承諾、合約變更等高風險動作,不應因為 Jev 回傳高 confidence 就直接執行。這些流程仍需要明確授權、規則檢查、最小權限與人工批准;模型只能提供一個可供審核的訊號。
導入前的四步驗證
步驟 1:定義未知選項與 schema
先寫清楚 state 的來源、版本、敏感欄位與有效期限,再為每一題定義 Choice 的選項、Score 的 rubric 或 Noul 的明確敘述。把 unknown、資料不足與需要人工覆核列為正式路徑;不要讓空白答案偷偷落到「其他」。需求盤點方式可參考 AI 商業落地第一步。
步驟 2:用去識別資料建立人工對照
抽取去識別化的歷史案件,由熟悉流程的人員標記,保留標記理由與分歧案例。用同一批資料比較現行規則、現用 LLM 與 Jev,分開記錄準確性、未知率、人工覆核量與失敗類型;不要把 TypeSafe workflow eval 的 reference prediction 當成你公司的真值。
步驟 3:影子測試誤判、校準與全程延遲
讓 Jev 只觀察、不改變正式流程,檢查混淆矩陣、各 confidence 區間的實際命中率、資料漂移、惡意輸入、逾時率與人工接手比例。同時量測從請求、資料查詢到回傳與人工決策的全程 p95,不只記錄模型單次數字;成本也應按整條 workflow 計算。台灣企業導入 AI Agent:真正要算的不是 token,而是工作流成本
步驟 4:低風險小範圍上線,保留逾時與回滾
先選低風險、可回復的流程,設定保守門檻、逾時轉人工、錯誤告警、權限邊界與回滾開關。把通過條件寫成可驗收紀錄後才擴大範圍;若結果不穩定,退回規則或人工處理,不要用增加重試掩蓋問題。需要協助界定試行範圍時,可聯絡優創智能。
結論:把 Jev 當成可驗收的判斷元件
Jev 的核心不是讓 AI 更像一個會聊天的人,而是讓範圍明確的判斷以 typed values、機率與程式規則接進 workflow。它的價值要由企業自己的資料、校準結果、人工覆核負擔、p95 延遲與完整成本證明;它的限制也同樣清楚:型別安全不等於語意正確,confidence 不等於核准權限,early access 也不等於成熟 SLA。
因此,合理的第一個問題不是「Jev 能不能取代 LLM」,而是「我們能不能定義一個有 unknown、有人工接手、可回放且低風險的決策問題?」能回答這題,再用四步驗證,才有足夠證據判斷 Jev 是否適合你的企業。
來源與查閱日期
- TypeSafe AI,〈Introducing System One Models & Jev〉,2026-09-14。官方文章
- 寶玉(@dotey),Jev 與 System One 模型介紹,2026-09-16。X 貼文
- TypeSafe Docs,〈Introduction〉,查閱 2026-09-16。官方文件
- TypeSafe Docs,〈Confidence〉,查閱 2026-09-16。官方文件
相關推薦與延伸閱讀
- 5 個行政自動化場景:會議、郵件、排程與報表驗收:從會議摘要、郵件草稿、社群排程到費用及定期報表,整理行政自動化的輸入、人工覆核與驗收方式,不把工具設定完成當成效益保證。
- Claude Agent SDK 每月 $100 額度教學:Anthropic Max 5x 政策解析與台灣企業導入指南:Anthropic Max 5x 使用者每月可領 $100 Claude Agent SDK 額度,不佔訂閱限制。了解政策細節與台灣企業的導入方式。
- Cloudflare AI Gateway 免費層:替 AI API 加上觀測與成本護欄:用 Cloudflare AI Gateway 的免費核心功能集中管理 AI 請求,實作 logging、cache、rate limiting 與 GEO 查