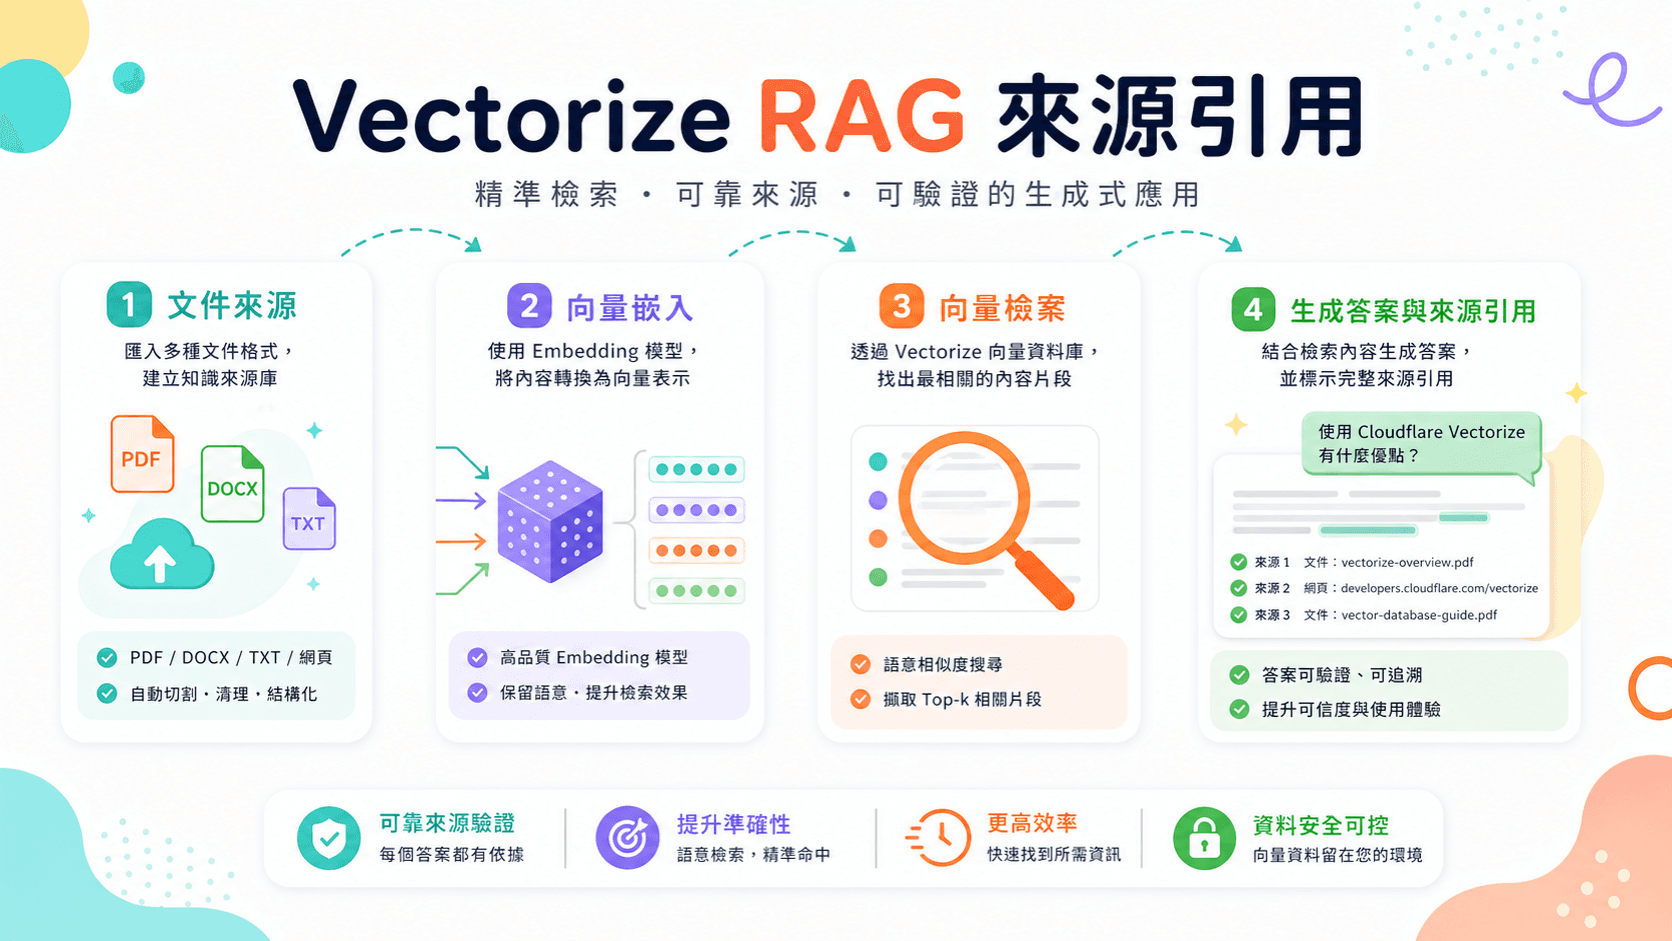
RAG 的價值不只是讓模型「知道更多」,而是讓回答能指出它依據哪一段資料。Cloudflare Vectorize 官方定價頁(2026-04-21)列出 Workers Free 每月 30 million queried vector dimensions 與 5 million stored vector dimensions;額度以維度計算,不是以文件筆數計算。
先做向量預算
假設每個 chunk 使用 384 維 embedding,儲存 5,000 個 chunk:
5,000 × 384 = 1,920,000 stored dimensions
這低於 5 million 的免費儲存額度。查詢預算也要估算:每次取 5 個候選向量、每天 100 次查詢、每月 30 天,約為 5 × 384 × 3,000 = 5.76 million queried dimensions。用這個方式估算,才能知道是資料量還是查詢量先碰到上限。
資料模型要保留 citation metadata
每個向量除了 embedding,至少保存:
type ChunkMetadata = {
  source_url: string;
  title: string;
  text: string;
  page_version: string;
  updated_at: string;
};
查詢流程是「embed 問題 → Vectorize top-k → 把 chunk 與 URL 傳給模型 → 回傳 answer 與 citations」。模型只能使用命中的 chunk,找不到足夠證據就回傳 insufficient_evidence,不要用常識補完。
GEO 引用回歸測試
固定 10 個問題,每題保存 query_id、top-k 結果、回答、source_url 與 faithful。逐句比對回答和 chunk 原文;如果模型省略「僅限特定方案」等條件,這筆就標記為失敗。把「沒有檢索到」和「檢索到但回答錯」分開,修復方向才清楚。
超過免費額度時怎麼辦
先減少重複 chunk、提高切分品質,再調整 top-k;不要直接把維度換高。官方文件表示查詢與儲存維度是主要計價單位,HTTP API、Workers API 與 Wrangler 查詢都會計入用量;資料傳輸不另收費。正式上線前,在 dashboard 觀察實際維度而不是只看文件數。
最小 smoke test
npx wrangler vectorize create geo-demo --dimensions=384 --metric=cosine
npx wrangler vectorize list
接著用一份 20–50 段的公開 FAQ 建立索引,對 10 題固定查詢保存 top-k 與來源 URL。空索引不會計入儲存維度,但查詢 API 與 CLI 都應納入測試紀錄。
來源
- Cloudflare Vectorize 定價,官方文件,2026-04-21 更新。
- Vectorize 入門,Cloudflare 官方文件。
- Workers AI Embeddings,Cloudflare 官方文件。
本文的 citation metadata、faithful 欄位與 RAG smoke test 是 YOTRON 的 GEO 工程建議,不是 Vectorize 的排名保證。
相關推薦與延伸閱讀
- Cloudflare 推出代理就緒度分數:用四大維度檢查你的網站對 AI Agent 是否準備好:Cloudflare isitagentready.com 用四大維度替網站的 AI agent 就緒度打分。本文解析評分邏輯與官方歷史樣本,說明採用率為何不等
- Cloudflare AI Gateway 免費層:替 AI API 加上觀測與成本護欄:用 Cloudflare AI Gateway 的免費核心功能集中管理 AI 請求,實作 logging、cache、rate limiting 與 GEO 查
- Cloudflare Workers AI 教學:API Key 取得與免費額度呼叫實戰:想零成本串接開源大模型?本文手把手教你取得 Cloudflare Workers AI 的 Account ID 與 API Token,完整解析每日免費額度計