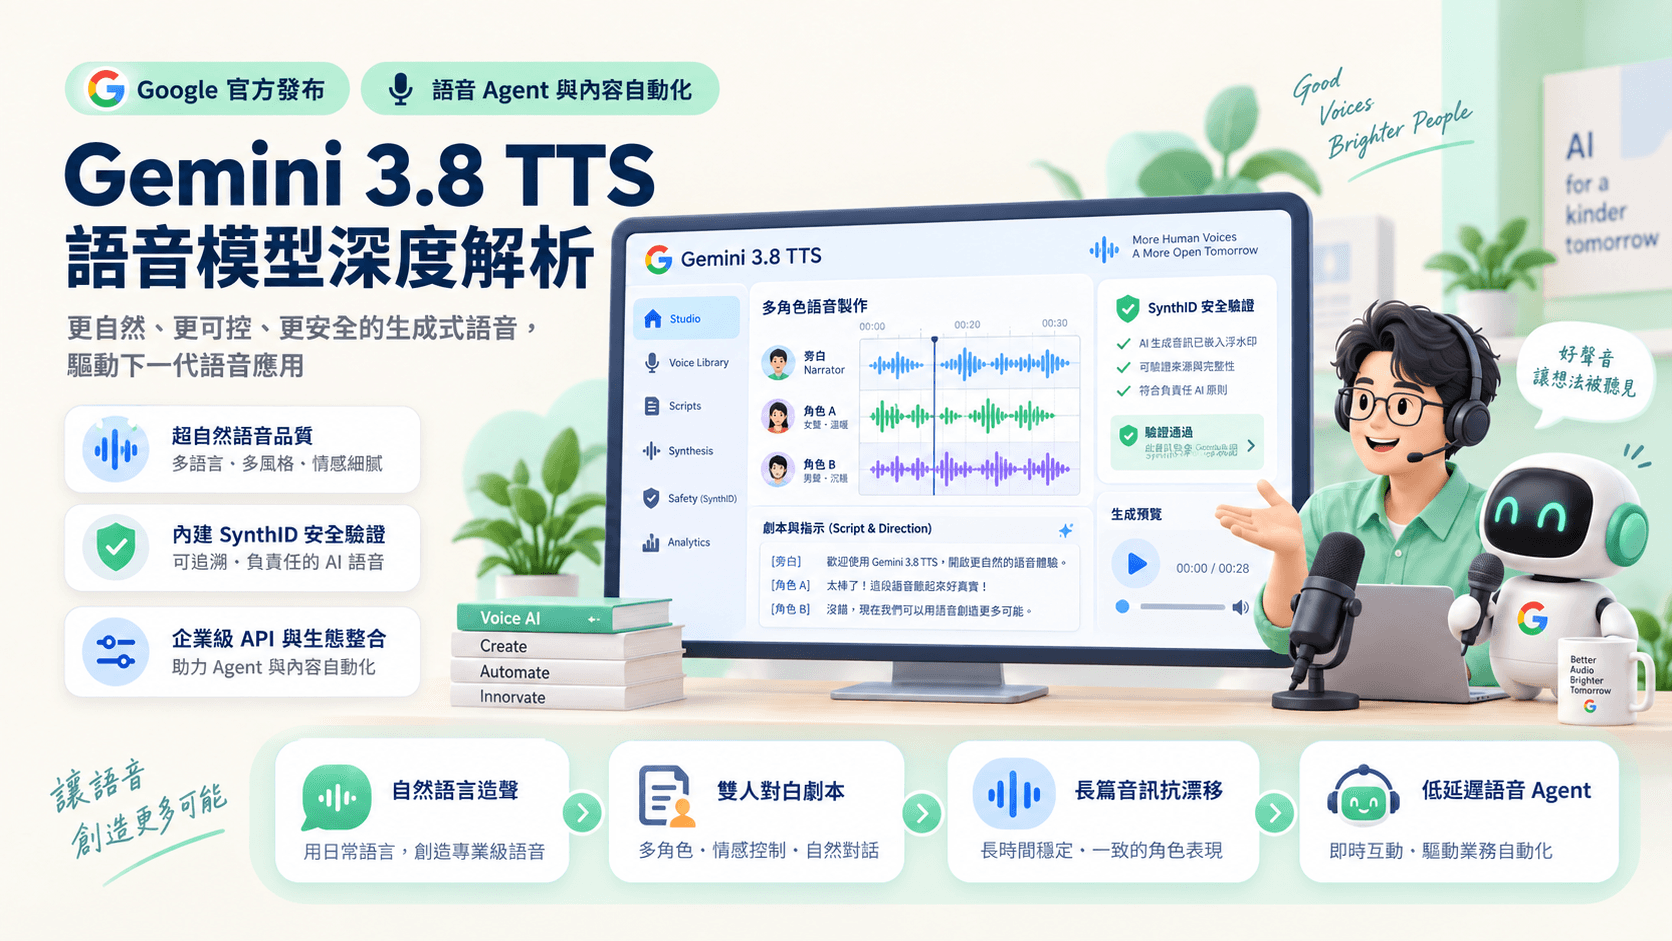
Google 於 2026 年 9 月 23 日正式發布了專為音訊生成設計的全新模型家族成員:Gemini 3.8 Flash TTS 與 Gemini 3.8 Flash-Lite TTS。
長期以來,企業在建構語音 AI 應用時,往往面臨兩個兩難困境:一是用固定預設音色(Preset Voices)雖然穩定但缺乏品牌識別度,聽久了極易產生機械感;二是雖然有聲音複製技術,但模型在長篇朗讀或劇本對白中容易出現「音色漂移(Voice Drift)」或無法精準控制語音情緒與停頓節奏。
Gemini 3.8 語音模型最大的突破,在於將傳統「靜態語音合成」升級為「可全方位導演的動態聲音工作室」。本文從技術原理、核心能力、評測基準出發,為企業技術決策者與產品團隊梳理落地實戰指南。
雙模型定位:創意導演 vs. 規模吞吐
針對不同的商業使用場景,Google 本次釋出了兩種不同特化架構的模型:
| 特性比較 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 主要定位 | 深度創意導演、角色聲音設計 | 高併發規模化、高成本效益、低延遲 |
| 核心優勢 | 自然語言造聲、逐行劇本導演、多角色切換 | 高吞吐配音、大規模語音互動、即時客服 |
| 聲音庫支援 | 2,000+ 內建音色 + 無限 Prompt 自定義 | 支援龐大音色庫與標準參數微調 |
| 典型場景 | 有聲書、Podcast 劇本、角色遊戲、沉浸廣告 | 呼叫中心 Agent、外語在地化配音、大量通知系統 |
| 整合途徑 | Gemini API / Google AI Studio / Gemini Notebook | Gemini API / Google AI Studio / Google Vids |
四大核心技術突破解析
1. 自然語言造聲(Generative Voice Design)
過去企業若想打造專屬品牌語音,通常必須耗費數十萬預算聘請專業配音員進錄音室錄製數小時語料,並進行繁瑣的模型微調。
Gemini 3.8 Flash TTS 實現了純 Prompt 驅動的音色生成。企業只需要在系統提示詞中描述角色的年齡、性別、口氣特徵、職業背景與口音細節(例如「帶有微微墨爾本口音的活力 DJ」或「冷靜權威但語氣溫和的金融風控分析師」),模型即可從零生成原創音質。支援涵蓋超過 100 種語言與地方方言變體,生成後還能儲存音色 ID 進行持久化引用,解決長期專案的聲音一致性問題。
2. 劇本級逐行導演(Line-by-line Direction)與原生雙人對白
一般的 TTS 引擎只能設定全域的速度或音調,面對需要情緒起伏的對話時往往顯得生硬。Gemini 3.8 TTS 允許開發者在單一腳本中對每一句台詞進行「導演級標記」:
- 情感與語氣切換:從開場的沉著專業,到解釋複雜問題時的放慢語速,甚至耳語、急促警示等不同情境。
- 原生雙角色場景調度:在同一份腳本中定義多個發話者,模型能夠在保持各角色音色獨立分明的同時,展現極其自然的輪流發言節奏(Turn-taking),不會出現前後語音切斷或音量突變的瑕疵。
3. 長篇音訊抗漂移與細膩非語言口語聲(Backchanneling)
有聲書或長篇教學內容過去是 AI 語音的一大罩門,許多模型在連續生成 15 分鐘後,音色或咬字頻率會悄悄改變。Gemini 3.8 顯著強化了長上下文下的語音穩定性,能維持數小時連續輸出的聲線一致。
此外,模型導入了非語言口語反應聲與傾聽反饋(Backchanneling),包含思考時的輕微停頓、自然笑意、咳嗽聲,以及在對話中代表傾聽與認同的「嗯哼(mhm)」、「沒錯(yeah)」,大幅消除了過往 AI 語音「過度完美而冷冰冰」的機器感。
4. 30 秒語音複製與企業安全防護(SynthID & C2PA)
在合法授權前提下,企業僅需提供 30 秒清晰音訊範例即可快速建立聲音模型。為了杜絕 Deepfake 詐騙與身分盜用風險,Google 建立了一套合規安全機制:
- 口頭同意驗證(Verbal Consent Verification):使用者必須上傳一段由原聲音擁有者朗讀的口頭同意聲明,系統會透過語音特徵比對確認同意聲明與樣本來自同一人。
- SynthID 隱形音訊浮水印:所有生成的音訊檔均會被寫入不影響人耳聽覺的深層特徵碼,即使經過壓縮、轉碼或剪輯,專屬偵測工具仍能驗證其 AI 生成來源。
- C2PA 憑證標準:符合國際內容真實性與溯源標準,協助企業在發布內容時保護版權並符合監管透明度要求。
(註:AI Studio 上的聲音複製功能因各地法規差異,目前在美國部分州、歐盟經濟區、英國等地設有限制。)
國際基準評測數據表現
在公正第三方評測方面,Gemini 3.8 語音模型展現了領先的水準:
- Hume AI Voice Design Benchmark:Gemini 3.8 Flash TTS 拿下總分 71.4 分 奪得全球第 1 名,在口音精準模擬(Accent Modeling)維度亦以 60.8 分 拔得頭籌。
- Hume AI Overall Quality Index:Gemini 3.8 Flash TTS 與 Flash-Lite TTS 分別包辦全場 第 1 名與第 2 名。
- Voice Arena 盲測人類偏好榜:在跨語系(包含日語、巴西葡萄牙語、越南語、現代標準阿拉伯語、墨西哥西班牙語、印地語等)的人類聽覺評測中,雙模型均穩居第一梯隊。
台灣企業三大高價值落地場景
對於正在規劃導入生成式 AI 的企業而言,Gemini 3.8 TTS 不僅是多媒體創作工具,更是建構新一代「多模態語音 Agent」的核心拼圖。
情境一:全通路智慧語音客服與出海接待
結合優創智能先前分享的 gpt-realtime-2 客服實戰經驗,企業可以透過語音模型打造專屬虛擬專員:
- 品牌專屬語音識別:為品牌設計專屬聲音形象,統一官網語音助手、電話總機、LINE 官方帳號語音訊息的聽覺體驗。
- 多語系出海拓客:面對東南亞或歐美海外客戶時,系統能以標準且親切的當地口音進行第一線預約確認或詢價諮詢。
情境二:自動化影音產線與教材在地化
企業內部培訓手冊、產品說明書、軟體操作 Demo 通常需要大量旁白:
- 一鍵轉教學 Podcast / 有聲手冊:將內部知識庫(如 SOP 文件)直接轉化為具有主持人和專家雙人互動討論的音訊節目。
- 低成本影音後製:搭配 Google Vids 等工具,原本耗費數天的人工錄音與重錄成本,可縮減至分鐘級別完成。
情境三:沉浸式導覽與線下數位互動
展覽館、門市智慧機台或零售場景中,語音能傳遞比純文字更有溫度的服務體驗。透過 Gemini 3.8 Flash-Lite TTS 的低成本優勢,企業能以極具競爭力的 API 成本,讓每一位顧客都能享受即時、細膩的互動式語音導覽。
企業評估與導入四步法
若您的團隊計畫在接下來季度將語音能力導入現有產品或業務流程中,建議採取循序漸進的實施步驟:
- 情境挑選與目標量化:優先挑選「文字已標準化、但需要聲音傳達溫度」的場景。評估前可參考優創智能的 AI 導入 POC 評估指南 設定驗收標準。
- 聲音風格規格化(Voice Persona Spec):撰寫明確的 Prompt 規範,定義角色的年齡感、語速基準、稱謂習慣,並在 AI Studio 中固定其自定義語音識別碼。
- 人機邊界與安全合規設計:建立合規機制,所有外發生成內容保留 C2PA 標籤,並設計敏感個資與客訴情境的「即時轉接真人」機制。
- 架構整合與快取策略:針對重複率高的靜態回覆(如營業資訊、政策宣告)實施邊緣音訊快取,高動態內容才即時呼叫 API,兼顧極致體驗與預算控管。
總結
Gemini 3.8 TTS 的釋出象徵著 AI 語音技術從「機械朗讀文字」正式邁入「具備情感表現力的音訊表演時代」。無論是追求極致品牌聲線的創意設計,抑或是追求大規模運行的低成本語音代理,企業現在都擁有了更強大且安全的技術工具。
優創智能持續協助企業梳理 AI 落地架構與自動化流程。如果您希望為企業打造專屬的語音 AI 解決方案,歡迎與優創智能技術團隊預約深入探討。
相關推薦與延伸閱讀
- gpt-realtime-2 是什麼?語音 AI 客服自動化實戰指南:gpt-realtime-2 是什麼?本文整理它的語音理解、即時回應與多語言能力,說明台灣中小企業如何用語音 AI 做客服、接待與翻譯,涵蓋多語言前台接待、下班
- AI Agent 進入 Production 前,FDE 要先建好控制面:企業 AI Agent 的關鍵不是 demo,而是把權限、成本、觀測、評估與人工升級,做成可營運的控制面。本文從三個近期訊號說明權限、成本與安全為何要一起設計,
- Microsoft 重整 Copilot:企業 AI 正從聊天介面走向可執行的工作代理:Microsoft 於 2026 年 9 月 25 日公布新版 Copilot,加入 Home、Code、Autopilot 工作區與 Office 應用整合。