GEO 的目標不是讓生成引擎「不加思索地引用你」,而是讓它在有充分證據時,能找到、理解並正確引用你的內容。本文所稱惡意 GEO,指以操縱答案為目的的改寫;正常修正事實、增加來源或改善可讀性,不應只因引用增加就被判定為惡意。
最新研究帶來的工程警訊
2026-09-02 提交至 arXiv 的預印本提出 GEO Defender,專門研究惡意 GEO 改寫文件的防禦。研究指出,這類文件可能仍然與原文保持事實一致,因此只靠事實核對或語言模型困惑度過濾並不夠。摘要報告在兩個閉源與三個開源模型、七種攻擊設定中,將平均攻擊成功率由 50.32% 降至 6.20%,同時保留 94.12% 的良性證據使用率。
本文核對原始摘要,未重現模型、資料或實驗。這些數字是研究環境的結果,不是任何網站上線後可以直接承諾的成效。GEO Defender 是搜尋系統側的防禦設計,本文的網站內容查核不等同部署該方法。對網站經營者的工程啟示是:引用率升高不等於來源品質升高,評估必須同時觀察「是否被引用」與「是否被正確使用」。
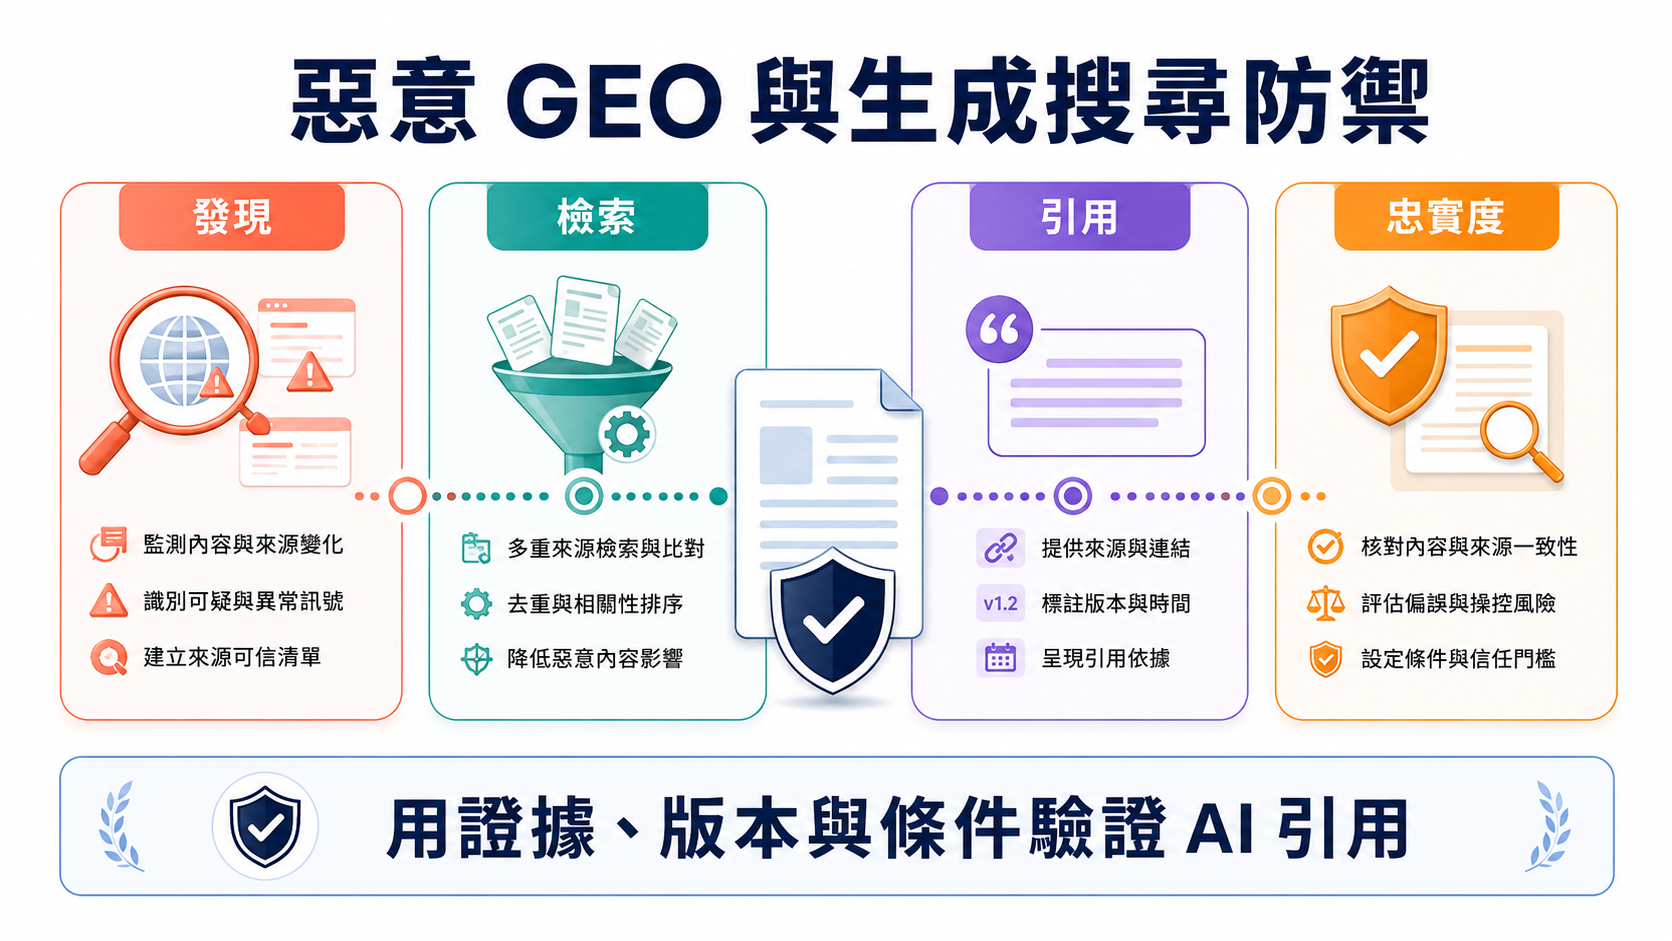
把 GEO 風險拆成四個可測量面向
| 面向 | 要回答的問題 | 最小證據 |
|---|---|---|
| 發現 | 受測來源是否取得正式頁面? | 已驗證 crawler 與同次 HTTP/正文證據;sitemap 僅提供入口 |
| 檢索 | 回答是否使用正確版本? | 自建系統檢索追蹤;外部系統缺證據則未知 |
| 引用 | 是否引用了真正支持主張的頁面? | 引用 URL 與原文段落 |
| 忠實度 | 是否保留條件、限制與適用範圍? | 主張對照表與人工抽查 |
Google 的 AI features 文件仍要求網站遵循一般 Search 基礎:頁面要能被抓取與索引,重要內容要以文字提供。這代表 robots.txt、sitemap、內部連結與初始 HTML 仍是 GEO 的底座;但它們可用於排查發現與存取問題,不能保證引擎找到頁面,也不能回答「引用是否正確」。
用主張對照表防止「看似正確」的改寫
不要只記錄品牌有沒有出現在答案中。為每篇重要文章建立可審查的主張表:
claim_id: geo-001
claim: 研究提出一個不需微調目標模型的兩階段防禦流程
source_url: https://arxiv.org/abs/2609.02964
source_date: 2026-09-02
conditions: 研究中的七種 GEO 攻擊設定
last_reviewed: 2026-09-09
每次內容或來源更新時,至少檢查:
- 主張是否仍能由原始來源直接支持。
- 數字是否保留研究條件與量測範圍。
- 摘要是否把「研究結果」誤寫成「保證效果」。
- 連結是否仍指向正式 HTTPS 網址,且沒有被重新導向到未知網域。
這個方法的重點不是把文章寫得更像論文,而是讓編輯、工程師與日後的 agent 都能追溯每個高風險主張。
以固定查詢集測量,而不是追逐單次答案
依業務範圍建立固定繁體中文查詢,涵蓋品牌、服務比較、限制條件與反向問題。事前決定題目與重複次數,分開品牌控制題及需求題;記錄引擎、模式、時間、地區與發布版本。每次發布後保存:
query -> answer snapshot -> cited URLs -> supported claims -> omitted conditions
把結果分成四個指標:
retrieval_rate:僅在有檢索追蹤時,以取得目標頁的成功檢索次數除以可觀察的成功檢索總次數;公開引擎缺追蹤則標未知。citation_rate:引用目標正式 URL 的回答數,除以來源完整可判讀的回答數;品牌提及另計。support_rate:來源支持的主張數,除以實際查核的引用主張數;揭露抽查範圍。condition_preservation:正確保留的必要條件數,除以預先標記且適用於該回答的必要條件數;不適用與未知分開。
分母為零不報 0%,而標記無可評估樣本。來源缺漏保留未知,執行失敗不視為未引用;揭露預定與完成次數。若引用增加但支持度下降,先核對回答與來源差異,不直接推定惡意攻擊或官網內容有錯。
防禦清單:內容、來源與存取分開治理
生成搜尋的風險不能只靠一個檔案解決。建議把三層分開:
robots.txt與 crawler 政策:定義哪些自動化請求可以存取。- sitemap、canonical 與內部連結:提供穩定的發現路徑。
- 文章與引用資料:用清楚主張、日期、條件與原始連結降低誤用。
llms.txt 是供支援它的 agent 使用的導覽提案,不是存取控制或引用保證;不能由檔案存在推論平台給予排名加分。任何由它列出的 URL、指令或第三方資源,都應像公開供應鏈輸入一樣檢查網域、HTTP 狀態、內容標題與變更紀錄。
YOTRON 可直接採用的發布閘門
以下是使用自有網址執行的初步讀取範例,example.com 為佔位;不是 GEO Defender 實作或完整安全檢查:
curl -fsSL https://example.com/robots.txt
curl -fsSL https://example.com/sitemap.xml
curl -fsSL https://example.com/article | rg -n '<title>|canonical|主要主張'
這些命令只能確認部分回應文字,不能證明來源可信或防禦有效;rg 不會解析完整頁面,仍須檢查重新導向、正文與資料一致性。接著由審閱者以主張對照表檢查高風險句子,並揭露覆蓋範圍。發布後再用固定查詢集保存回答、引用 URL 與條件遺失情況。若來源被錯誤引用,先記錄可重現案例,再修改最接近根因的頁面或來源,不要用更多關鍵字堆疊掩蓋問題。
來源與判讀界線
- When Optimization Becomes Manipulation: Defending Generative Search against Malicious Generative Engine Optimization,2026-09-02:原始研究與 GEO Defender 實驗結果。
- Google Search Central:AI features and your website,持續更新:AI 搜尋功能沿用可抓取、可索引與文字內容等 Search 基礎要求。
- Alon Hertz:Data Became Code,2026-08-26:文件指令與供應鏈風險的第一手研究者報告,本文未重現。
- Discourse:Automatically generated llms.txt,2026-09-02:說明產品對
llms.txt、sitemap、robots.txt與 crawler 控制的採用現況。
研究中的攻擊成功率與防禦數字只適用於論文設定;四層測量、主張對照表與發布閘門是 YOTRON 的工程建議,不是平台公開的排名演算法。
結語
可靠的 GEO 不只是增加被看見的機率,而是讓機器在引用時有足夠證據、正確版本與清楚限制。把發現、檢索、引用與忠實度拆開測量,才能知道可見度改善究竟帶來價值,還是只放大了內容操縱風險。
相關推薦與延伸閱讀
- 一般商家為什麼要做 GEO?從被找到到被正確引用的落地指南:GEO 不只是大型企業的品牌工程。本文用一般商家的客戶旅程拆解 AI 搜尋能見度,提供可驗證的內容、存取、結構化資料與成效量測做法:建立商家事實表、讓每個服務都
- 一般商家的 GEO 內容契約:把地區需求放進可索引 DOM:Google 近期補充 local business query 支援並澄清 CSS content 不屬於可索引 DOM。本文把 GEO 對一般商家的價值拆成
- 一般商家為什麼要做 GEO?從地區需求到可驗證的 AI 搜尋答案:Google 近期補充 local business query 支援後,一般商家更需要把地點、服務、限制與證據整理成可被 AI 搜尋理解的公開頁面。本文提供低