AI 搜尋的 GEO 成效,不應只看品牌有沒有出現在答案裡。更重要的是:答案是否找到正確來源、是否把不同來源的主張混在一起,以及引用是否保留原文的條件與限制。多代理 RAG 可作為自建回答系統的測試架構;它不能控制公開搜尋平台的檢索或來源選擇。自建系統的回答品質與公開搜尋的 GEO 引用成效,必須分開驗收。
為什麼要拆成四個角色
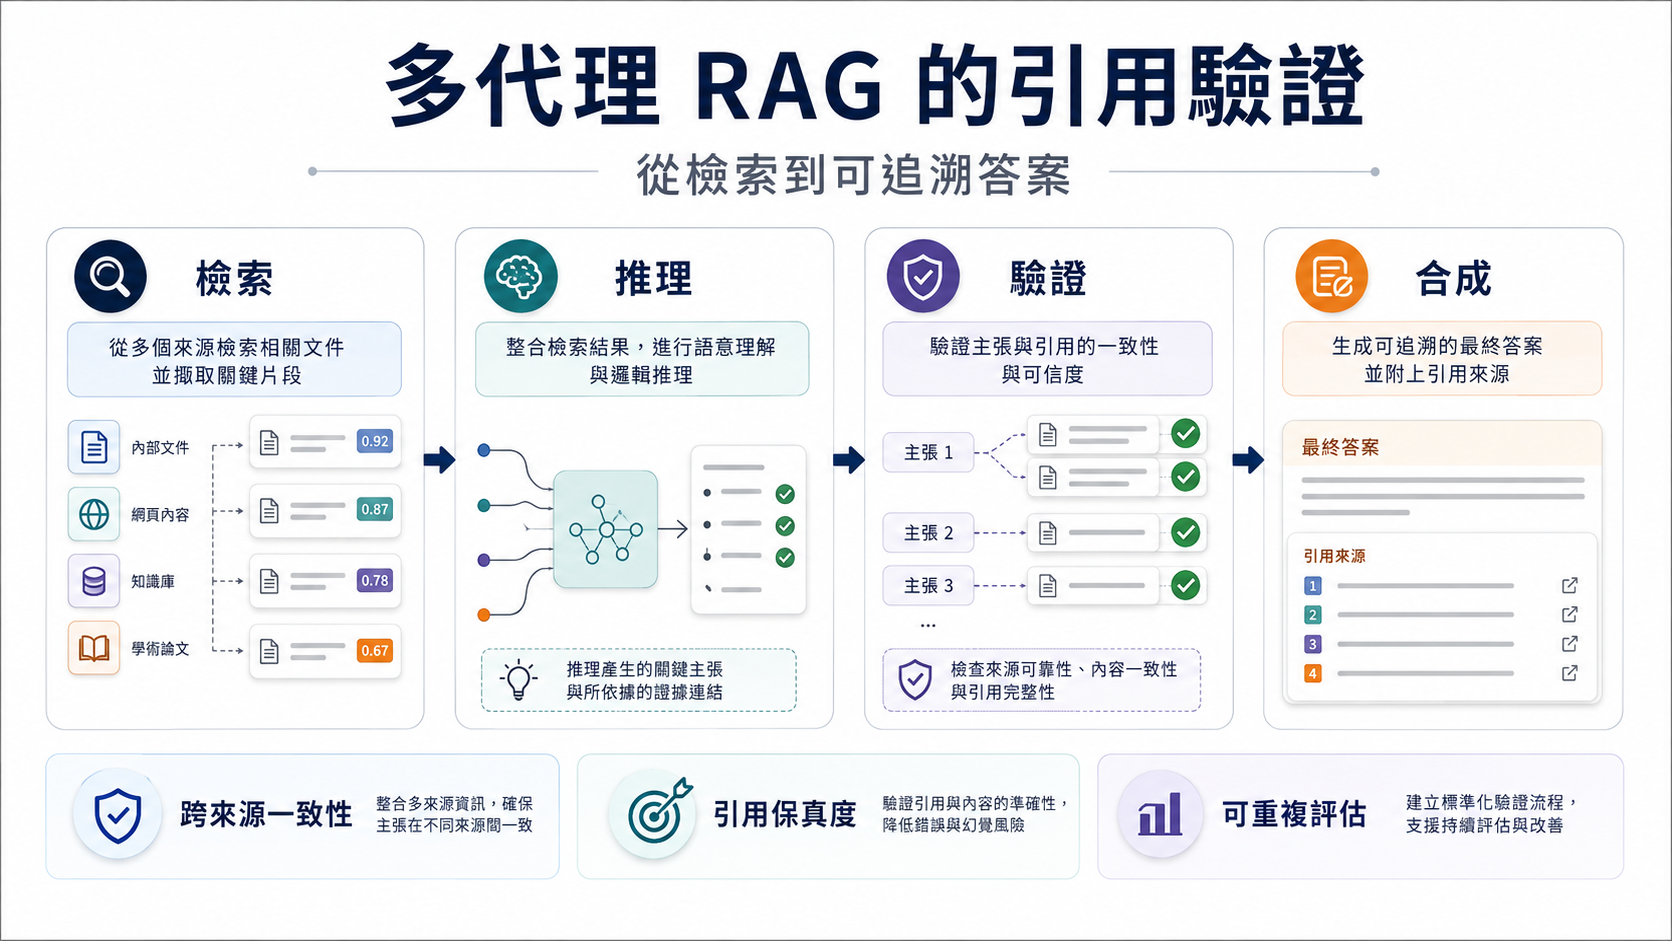
2026 年 9 月 1 日發表於 Scientific Reports 的 MARCO 研究,將知識密集型 RAG 拆成檢索、推理、驗證與合成四類代理,目的就是處理單一代理常見的檢索不完整、跨來源驗證不足與多步推理問題。這是研究提出的架構,不是所有 AI 搜尋平台都採用的公開標準;對 GEO 團隊而言,它提供了一個實用的測試分層。
- Retriever: 從網站、文件與知識庫取得候選證據,保存 URL、版本與段落。
- Reasoner: 把使用者問題拆成可查證的子問題,標示每個主張需要哪些證據。
- Validator: 比對來源的日期、範圍、數字與限制,拒絕互相矛盾或無法追溯的主張。
- Synthesizer: 只用通過驗證的主張生成答案,並附上對應引用。
上述角色是架構分工,不代表每個代理都會正確執行;驗證器也可能漏判,需人工抽查並與較簡單方案比較品質、延遲及成本。研究在指定問答資料集的表現,不能推論成網站曝光成長。
拆分的價值不是增加代理數量,而是讓失敗可以定位:是沒抓到來源、推理超出證據,還是引用連錯頁面。
分開保存提及、來源與判讀
不要把一次 AI 答案濃縮成單一「GEO 分數」。以下是假設的單一引用記錄,不是實測;多個來源需逐筆或以清單保存,尚未核對的值保留 unknown:
mentioned,cited_url,faithful,actionable
true,https://example.com/source,unknown,unknown
mentioned:答案是否提及品牌、產品或服務。cited_url:保存實際引用網址,再另判斷是否為本站或目標頁,不填入布林值。faithful:引用是否保留日期、條件、例外與限制。actionable:讀者能否依引用完成下一步,而不是只看到模糊結論。
例如答案提到服務並引用首頁,則記為品牌提及、本站引用,但未引用目標技術頁。保留實際首頁網址,再核對其是否支持對應說法;不能單憑此結果判定 canonical 或內鏈有問題。
可重複的驗證流程
1. 固定查詢與版本
依觀測目的建立固定問題,涵蓋品牌定義、方案比較、限制條件與實作步驟。每次執行記錄 query_id、引擎、語系、時間、頁面版本與答案 URL。另記錄模式、搜尋與登入設定、重複次數及失敗原因。相同條件下重跑,仍不能只憑前後差異判定因果。網站版本是觀測時版本,不代表引擎已索引該版本。
2. 逐主張綁定來源
把答案拆成最小可驗證主張,為每個主張保存來源 URL、原文段落與抓取日期。若一個句子同時包含產品能力與價格,至少拆成兩個主張,避免其中一半有來源、另一半靠模型補全。
3. 做跨來源一致性檢查
比較來源的名稱、日期、數字、適用範圍與否定條件。來源不一致時,不要用模型投票決定真相;標記為需要人工處理,或在答案中明確呈現差異。
4. 做引用保真度回歸
把每次答案與上一次的 cited_url、faithful、actionable 比較。引用數增加但保真度下降,不算成功。Google Search Central 目前仍建議沿用可索引內容、清楚結構與一般 SEO 基礎;沒有公開保證某個特殊 Schema 或單一 GEO 技巧能帶來引用。
小型實作資料表
以下仍為假設資料;來源不完整時保留未知,不把失敗觀測算成零引用。提及率與引用率分別使用可判定的回答數為分母,並列出成功、失敗及未知數;零分母標示無法計算。
query_id,engine,locale,run_at,page_version,mentioned,cited_url,faithful,actionable,answer_url
geo-001,example-engine,zh-TW,2026-09-06T09:00:00+08:00,example-version,true,https://example.com/source,unknown,unknown,https://example.com/answer
每週先看 cited_url 與 faithful 的變化,再對照頁面版本與抓取紀錄。不要把相關性誤認成因果關係:模型、地區、登入狀態與即時索引都可能改變答案。
來源與判讀界線
- Scientific Reports:Multi agent retrieval validation and knowledge reasoning for enhanced retrieval augmented generation,2026-09-01。研究提出四類協作代理與跨來源驗證方向。
- Google Search Central:針對生成式 AI 功能進行優化的指南,持續更新,2026-09-09 查閱。說明生成式 AI 搜尋仍依賴可索引內容與一般 SEO 基礎。
研究的四類代理由出版社摘要核對;本文未重現其實驗。四欄指標、資料表欄位與回歸流程是本文的工程化建議,不代表任何平台公布的排名公式。GEO 的可交付成果應是可追溯的來源、可重跑的查詢與能定位失敗原因的紀錄。
結語
把「被 AI 引用」改寫成一條可測試的資料管線:先檢索,再拆解主張,接著驗證來源一致性,最後只合成通過檢查的內容。當 mentioned、cited_url、faithful 與 actionable 分開記錄,內容團隊才能知道下一次要修的是可發現性、可理解性,還是引用品質。
相關推薦與延伸閱讀
- GEO 引用驗證:用固定查詢找出 AI 搜尋的真實缺口:AI 搜尋的曝光不是單一排名。本文把 GEO 轉成固定查詢、引用證據與正確性回歸測試,分開觀測條件、有效分母與失敗原因,避免從單次答案推定成效。內容包含如何定義
- GEO 實作:把網頁做成可被 AI 引用的技術契約:AI 搜尋能否正確引用網站,取決於可索引內容、主張與來源、引用驗證及可執行答案是否形成完整契約。本文提供可落地的頁面與評估方法:拆解四層頁面契約,說明如何讓代理
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試