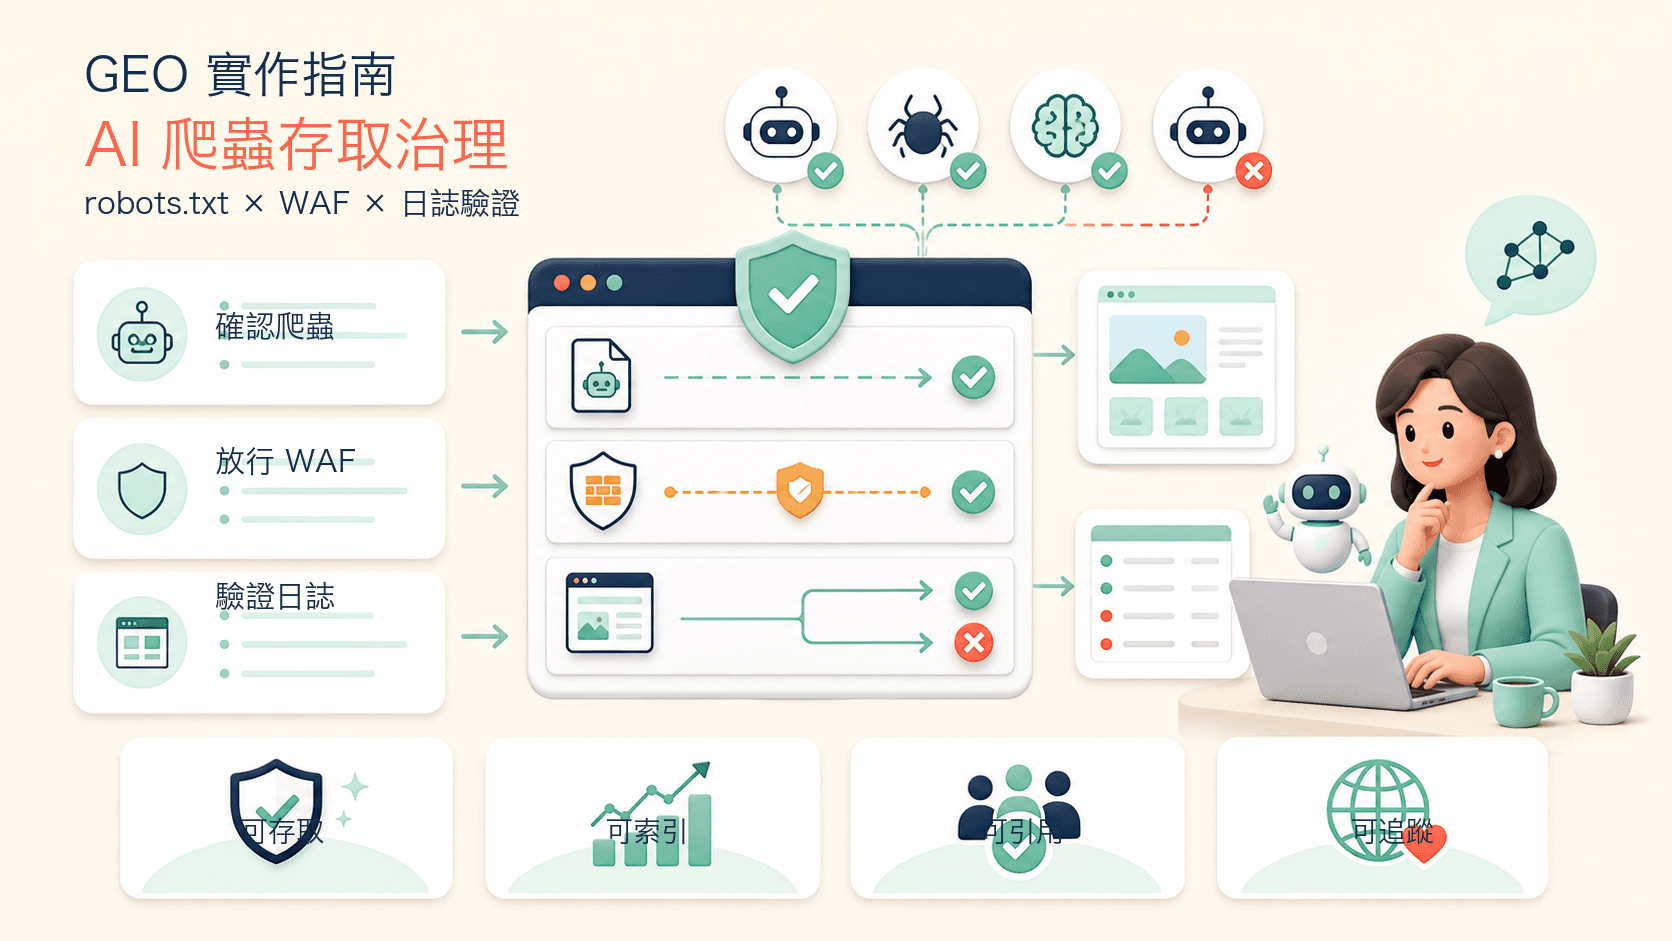
AI crawler 存取治理,是核對特定爬蟲的身分、政策與實際回應,排查內容取得障礙。本文檢查直接抓取路徑,不假設所有 AI 引用都來自當次官網抓取;平台也可能使用既有索引或其他來源。沒有引用時,先找證據,不預設一定被 WAF 阻擋。
先把三種控制分開
不要把所有 AI 存取問題都歸因於 robots.txt。它們處理的是不同層次:
robots.txt:公開宣告特定 crawler 可以抓哪些路徑。- WAF、Bot Management:依請求特徵決定 allow、challenge 或 block。
- 頁面控制:用
noindex、nosnippet或X-Robots-Tag控制搜尋結果呈現。
Google Search Central 說明,AI Overviews 與 AI Mode 沿用 Google Search 的基礎 SEO;沒有額外的 AI 檔案或特殊 Schema 要求。頁面仍須能被 Googlebot 存取、索引,且內容要以文字形式呈現。這代表「新增 AI 檔案」不能修復一個被 WAF 回傳 403 的頁面。
用請求路徑找出真正的阻塞點
建立經去識別化的存取事件表;路徑與 user agent 也可能帶有敏感內容,需先清理。以下是虛構範例,不是本站日誌:
observed_at,user_agent,path,status,content_type,waf_action,waf_rule,source_verified
2026-08-31T09:00:00+08:00,OAI-SearchBot,/blog/example,403,text/html,block,custom-rule-17,false
按以下順序比對:
robots.txt是否允許該 crawler 與目標路徑。- DNS/CDN/WAF 是否在應用程式前回傳 403、429 或 challenge。
- 應用程式 access log 是否看得到同一請求。
- 回應的
Content-Type是否是可解析的 HTML、Markdown 或 JSON,而非錯誤頁。 - user agent 是否需要來源 IP 或官方 IP range 驗證,避免把偽裝請求當成可信 crawler。
Cloudflare AI Search 文件特別提醒:Bot Management、WAF 或 Turnstile 的既有規則同樣會套用到 AI Search crawler;若希望它抓取網站,必須建立例外或 allow-list。這份文件指 Cloudflare 自建 AI Search 執行個體的爬蟲,不能當成 ChatGPT 或其他公開引擎的身分與設定。robots.txt 回傳 200,不代表後續文章請求真的通過 WAF。
Cloudflare WAF 的治理順序
若使用 Cloudflare AI Crawl Control,先檢查 WAF custom rules,再檢查 AI crawler 控制。Cloudflare 文件指出,AI Crawl Control 的 crawler block 會透過 WAF custom rules 執行,且 WAF 的處理順序在 pay-per-crawl 前面;既有 WAF 規則若先擋下請求,後面的 crawler 設定不會挽救它。
建議採最小放行範圍:
- 只放行已驗證、確實需要的 crawler。
- 只放行公開內容路徑,例如
/blog/、/docs/。 - 登入、管理介面、表單提交與 API 寫入端點維持阻擋或驗證。
- 為 allow、challenge、block 分別設定可搜尋的事件名稱與保留期限。
不要用「所有 bot 全部放行」測試 GEO。它會同時放大爬蟲成本、濫用風險與錯誤歸因;你也無法知道可見性變化是來自目標 AI crawler,還是無關流量增加。
Google crawler 與 Google-Extended 不是同一件事
Google 的 crawler 文件將 Google-Extended 定義為 robots.txt 的控制 token,而不是獨立的 HTTP user agent。它可控制內容是否用於 Gemini Apps 與 Vertex AI 的訓練或 grounding,但不影響 Google Search,也不是 Google Search 排名訊號。
因此,治理表要分別記錄:
Googlebot:Google Search 的抓取與索引路徑。Google-Extended:Google 其他 AI 系統的使用偏好 token。- 其他供應商 crawler:依各自公開文件與可驗證來源處理。
這個區分能避免兩個錯誤結論:把 Google-Extended 當成 Google Search crawler,或把阻擋 Googlebot 誤認成只會影響 Gemini。Google 明確說明,阻擋 Googlebot 會影響 Google Search 及其他 Google Search 產品。
發布前的三層測試
每次修改 robots、CDN 或 WAF 後,使用固定 URL 集合做回歸測試。以下命令需換成自己的公開測試網址,只檢查本機發出的請求:
curl -sS -L https://example.com/robots.txt
curl -sS -o /dev/null -w '%{http_code} %{content_type}\n' https://example.com/blog/example
curl -sS -A 'OAI-SearchBot' -o /dev/null -w '%{http_code} %{content_type}\n' https://example.com/blog/example
-A 只更換 user agent 字串,不會把本機請求變成官方爬蟲。這類模擬不能驗證官方來源 IP 的實際存取;200 與 HTML 類型也可能是挑戰或錯誤頁,必須另讀正文。
再把結果與 WAF 事件對照:
- 宣告層:
robots.txt是否符合預期。 - 網路層:目標請求是否得到 200,而不是 challenge、403 或 429。
- 內容層:HTML 有標題、正文、canonical、日期與來源,且沒有把重要資訊只放在需要互動的 JavaScript 中。
Google 建議用 URL Inspection 檢查 Googlebot 實際收到的 HTML。對其他 crawler,則以 access log 與供應商文件作為觀測證據。測試通過只證明受測條件下的回應。要確認官方爬蟲曾成功取得內容,還需核對已驗證來源與同一請求的邊緣/應用日誌;若 CDN 已回應快取,來源站沒有紀錄也不能直接判定被擋。索引與引用另行記錄。
來源與判讀界線
- Cloudflare AI Search:Website data source,2026-08-06:說明 WAF、Bot Management、Turnstile 規則會影響 AI Search crawler,並建議例外或 allow-list。
- Cloudflare AI Crawl Control with WAF,2026-08-03:說明 WAF custom rules、crawler block 與 pay-per-crawl 的處理順序。
- Google Search Central:AI features and your website,2026-09-09 查閱:說明 AI features 沿用 Search 基礎 SEO、沒有額外 AI 檔案要求,且索引與呈現不保證。
- Google Crawling Infrastructure:Google common crawlers,2026-07-14:說明
Google-Extended的控制範圍、它不是 HTTP user agent,也不影響 Google Search 排名。
上述文件支持 crawler 存取、WAF 順序、Google AI features 與 Google-Extended 的事實;事件欄位、三層測試與最小放行策略是本文的 YOTRON 工程分析,不是任何平台公布的排名公式。
結語
把 GEO 存取治理當成可觀測的網路管線:先確認 crawler 身份與 robots 宣告,再確認 WAF 實際動作,最後確認頁面回傳的是可引用內容。三層證據能縮小存取問題範圍,仍不能單獨判定沒有引用的原因。用固定題庫另外記錄回答與完整來源,保留未知,不把存取成功當成內容已被採用。
相關推薦與延伸閱讀
- GEO 實作:AI crawler 存取治理,為什麼 robots.txt 不是防火牆:robots.txt 只是意願宣告,不是防火牆。本文拆解 AI crawler 的意願宣告、流量觀測、強制封鎖與回歸測試四段治理流程,說明如何掌握誰在讀、讀什麼
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試
- AI SEO 怎麼做?中小企業的資料、內容與驗證流程:AI SEO 用 AI 協助搜尋資料分析、內容草稿與技術檢查。本文整理需要的資料、人工查核與三步試行,區分工作效率、搜尋成效及 GEO 引用。說明 AI 能協助
- SEO 文章怎麼寫?從讀者問題到發布驗收的五步指南:SEO 文章先回答讀者問題,再查核資料、組織內容與驗證頁面。本文提供五步寫作流程及編輯檢查表,分開觀察搜尋成效與 AI 引用:定義讀者要完成的決定、建立主張與證
- SEO 費用怎麼算?服務範圍、計價與預算比較指南:比較 SEO 報價,先對齊交付範圍與完整成本。本文整理月費、專案與成效計價的驗收問題,說明 GEO 額外工作及假設預算算例,並拆解報價應拆成哪些工作項目、三種計