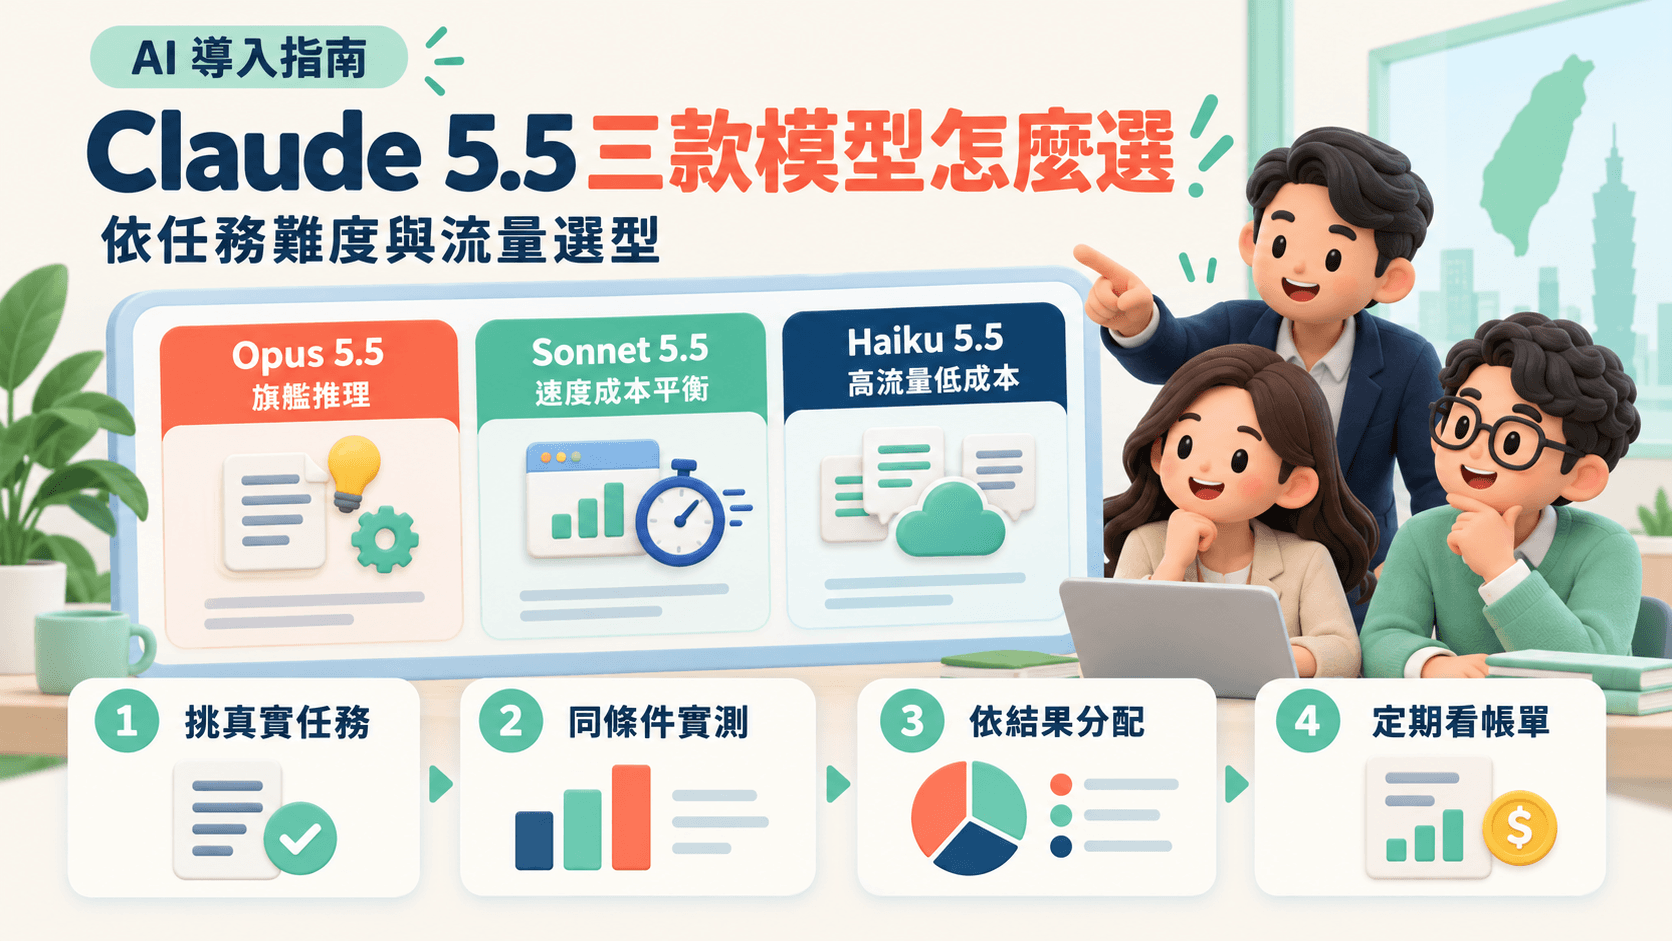
Claude 5.5 系列是 Anthropic 於 2026 年 9 月下旬至 10 月初陸續推出的三款模型,分別是旗艦 Opus 5.5、均衡型 Sonnet 5.5,以及輕量高流量的 Haiku 5.5。選型的核心結論很直接:依任務的難度與流量決定模型,而不是一律選最強或最便宜的那款。
三款模型一覽
| 模型 | 發布時間 | 定位 | 輸入 / 輸出(每百萬 token) |
|---|---|---|---|
| Claude Opus 5.5 | 2026-09-22 | 旗艦,複雜推理與長任務 | $4 / $20 |
| Claude Sonnet 5.5 | 2026-09-28 | 速度與能力的平衡 | $2 / $10 |
| Claude Haiku 5.5 | 已上線 | 高流量、低成本 | $0.10 / $0.50(輸入 10 萬 token 以內) |
Claude Opus 5.5:旗艦能力,價格下調
- 輸入 $4、輸出 $20,比 Opus 5 各降 20%;快取讀取降至 $0.20。
- Anthropic 表示,典型工作的執行成本比 Opus 5 低約 40%,輸出速度快 30% 以上。
- 廠商稱在多數公開評測上與 Claude Fable 5.1 相當或更好,而 Fable 5.1 定價為 $10 / $50。
- 廠商公布的評測:Terminal-Bench 4.0 66.4%、GDPval-AA v2.1 1846 Elo。
- 1M 上下文,輸出上限 128K。
Claude Sonnet 5.5:同價位,更快更省
- 價格與 Sonnet 5 相同,維持 $2 / $10。
- 速度提升 30% 以上,單一任務成本最多降 30%。
- 廠商公布的評測:Terminal-Bench 4.0 70.6%,高於 Opus 5.5 的 66.4%;OSWorld 2.1 80.1%;GDPval-AA v2.1 1844,接近 Opus 5.5 的 1846。
- 已在 AWS、Google Cloud、Azure 提供,模型 ID 為
claude-sonnet-5-5。
Claude Haiku 5.5:小模型,適合大流量
- 定位為最輕量、成本最敏感的模型,適合即時客服、瀏覽器操作與摘要分類,也能擔任 Opus 或 Sonnet 的編程子代理。
- 輸入 10 萬 token 以內為 $0.10 / $0.50;超過 10 萬 token 的提示為 $0.50 / $2.50。
- 平均比 Haiku 4.5 便宜約 75%,支援 1M 上下文、128K 輸出與可調 effort。
- 廠商公布的評測:GDPval-AA 1620、OSWorld 2.1 離線子集 72.4%、Terminal-Bench 4.0 39.2%。
怎麼選
- 需要最高推理品質或長時間複雜任務:Opus 5.5
- 日常開發與知識工作,兼顧速度與成本:Sonnet 5.5
- 大量請求、即時回覆、自動化分類:Haiku 5.5
導入前的實測步驟
步驟 1:挑出三到五個真實任務
從現有流程挑選代表性任務,例如客服問答、合約摘要、程式碼修改,並準備一組附標準答案的測試資料。
步驟 2:用相同條件比較
固定提示詞、輸入長度與評分標準,分別跑 Opus 5.5、Sonnet 5.5 與 Haiku 5.5,記錄品質、回應時間與單次任務成本。
步驟 3:依結果分配模型
把高難度任務交給較強的模型,把大量、標準化的請求交給 Haiku 5.5,並定期重新檢視 API 帳單。
導入提醒
- 本文數字多為廠商自述與第三方報導的整理,實際表現因任務而異。
- 善用 prompt caching 與 batch 處理降低成本,兩者在適合的場景下可明顯節省費用。
- 小模型價格持續下降,模型選型應定期重新評估,不宜一次定案。
參考資料
- OfficeChai:Claude Opus 5.5 benchmarks
- OfficeChai:Claude Sonnet 5.5 benchmarks
- StreetInsider:Anthropic launches Claude Haiku 5.5 with tiered pricing structure
- Computingforgeeks:Claude Opus 5.5 released
- AIWeekly:Anthropic ships Sonnet 5.5
相關推薦與延伸閱讀
- ChatGPT vs Claude:台灣企業的選型與試用比較方法:ChatGPT 和 Claude 怎麼選?用相同任務比較繁體中文、文件查核、搜尋來源、完整成本與資料設定,建立可重測的企業選型紀錄。本文提供五個維度比較表與三步
- AI Agent 的權限邊界怎麼設:企業導入前必須畫好的三條線:企業導入 AI Agent 前,權限邊界比模型選型更該先決定。本文用 2026 年 OpenAI–Hugging Face 事件與 Google Gemini
- AI 導入顧問怎麼選?台灣中小企業比較顧問與 DIY 的成本、風險與時程:要自己摸索 AI 工具,還是請 AI 導入顧問?本文用成本、時程、風險與適用情境四個面向比較 DIY 與委託,說明自己做的隱形成本、哪些情況請顧問更值得,以及挑
- Claude Design 正式推出:用對話創作設計稿,台灣企業實用指南:Anthropic 推出 Claude Design,讓非設計師靠對話產出原型、簡報與行銷素材。本文整理功能、適用對象與台灣企業落地建議,解析品牌設計系統繼承、
常見問題
複雜推理、長文件與多步驟任務選 Opus 5.5;日常開發、知識工作想兼顧速度與成本選 Sonnet 5.5;大量請求、即時回覆與自動化分類選 Haiku 5.5。選型前仍應以自家任務做小規模實測。
輸入與輸出價格分別從 $5 與 $25 降為 $4 與 $20,各降 20%;快取讀取降至 $0.20 per million tokens。Anthropic 另表示典型工作的執行成本約低 40%,但實際節省幅度依任務而異。
輸入 10 萬 token 以內為 $0.10 / $0.50(每百萬 token),超過 10 萬 token 的提示為 $0.50 / $2.50。估算成本時要依實際輸入長度分開計算,不能只看最低價。
不建議。評測數字多來自廠商自述與第三方報導,測試條件未必與你的工作相同。建議用真實資料、固定評分標準與相同題目比較兩到三款模型,確認品質、延遲與單次任務成本後再切換。