文/Laban(優創智能 AI 導入工程師)
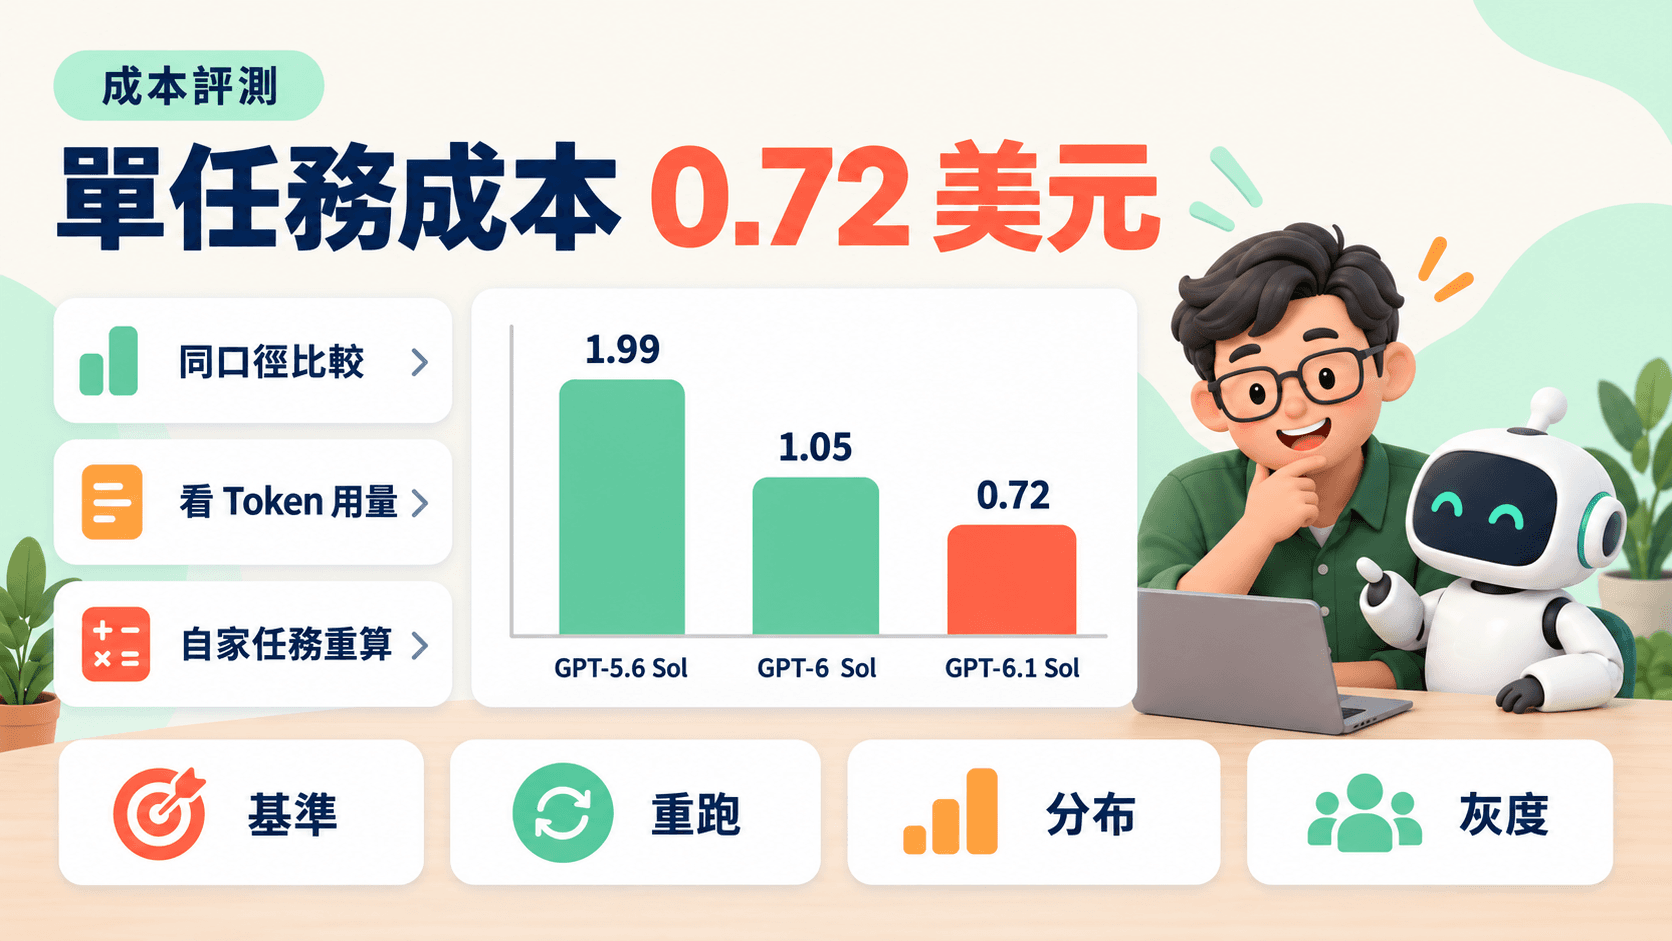
Artificial Analysis 的評測顯示,GPT-6.1 Sol 在最高推理強度下,每個任務的平均成本為 0.72 美元。結論先講:這是目前 Sol 系列最便宜的「接近 Astra 級」表現,但 0.72 美元是評測任務的平均值,不是你公司任務的報價單。 企業該做的不是直接引用這個數字,而是搞清楚它怎麼算出來,再用自己的任務重算一次。
模型發布本身的官方資料,見 GPT-6.1 Sol 上線:接近 Astra 的能力、五分之一價格。這篇聚焦第三方評測的成本數字怎麼讀。
一、數據怎麼說(已知事實)
以下取自 Artificial Analysis 於 2026-09-29 的評測文章與模型頁面(最高推理強度,每任務平均成本):
| 模型 | 單任務成本 | 相對 GPT-6.1 Sol |
|---|---|---|
| GPT-6.1 Sol | 0.72 美元 | 基準 |
| GPT-6 Sol | 1.05 美元 | 高約 46% |
| GPT-5.6 Sol | 1.99 美元 | 高約 2.8 倍 |
| GPT-6 Astra | 3.26 美元 | 高約 4.5 倍 |
換個方向看:GPT-6.1 Sol 比 GPT-6 Sol 低約 31%,比 GPT-5.6 Sol 低逾 63%,約為 Astra 的 22%。
其他同一來源的重點:
- 智慧程度:GPT-6.1 Sol 在 Intelligence Index 上僅比 GPT-6 Astra 低 1 分,比 GPT-6 Sol 高 4 分(最高推理強度)。
- 程式代理:Coding Agent Index 上,GPT-6.1 Sol(xhigh)比 GPT-6 Astra 高 1 分,成本不到 Astra 的 15%。
- 標準價格:輸入每百萬 Tokens 2 美元、輸出 10 美元、快取折扣 95%。
- 用量:GPT-6.1 Sol 的輸出 Token 比 GPT-6 Sol 多約 10%–30%,但低與中推理強度設定在 Token 效率上屬於帕雷托最佳。
二、為什麼單價相同,成本還能降(編輯分析)
單任務成本 = 單價 × 用量。GPT-6.1 Sol 與 GPT-6 Sol 的標準價格相同,所以差距來自用量面:
- 做對的比例更高:減少失敗後重跑,等於少付一次完整任務的錢。
- 快取命中:代理每一輪都重送上下文,快取價只有標準輸入價的 5%。
- 推理量的取捨:模型更聰明,不見得需要最高推理強度;較低強度就能達到相近品質,成本才會顯著下降。
同時要注意相反方向的陷阱:輸出 Token 增加 10%–30% 代表「單價相同」不等於「帳單相同」。預算要以每任務實測成本為準,而不是以價目表推算。
三、三個常見誤讀
- 把 0.72 美元當自家任務成本:評測任務的長度、工具呼叫與上下文都和你的不同。
- 只比 Max 強度:多數生產環境不會跑最高推理強度,低、中強度的成本與品質曲線才是實際決策依據。
- 忽略延遲與成功率:便宜但慢、或需要人工補救的流程,總成本不一定低。
四、企業重算 AI 代理成本的四步驟
步驟 1:從日誌取得現況基準
整理過去 30 天按任務類型分類的模型、推理強度、輸入/輸出/快取 Token 與重試次數,算出目前「每個成功任務」的成本,而不是每次呼叫的成本。
步驟 2:用 30–50 個自家任務重跑
分別以目前模型與 GPT-6.1 Sol 的低、中、高三種推理強度執行,記錄:
- 成功率(以人工或既有驗收規則判定)
- 每個成功任務的成本
- 平均延遲
- 輸出格式是否仍符合下游系統
步驟 3:算出分布,而不是只看平均
成本通常是長尾分布:少數長任務吃掉大部分預算。記錄中位數與 90 百分位,並為每個任務設定 Token 或步驟上限,避免代理無限重試。可搭配 AI 代理生產控制平面 的設計。
步驟 4:分層與灰度,保留退回路徑
Luna 等級處理低風險大量任務,Sol 為預設,Astra 只保留給少數高風險任務。先切 10%–20% 流量觀察一到兩週,模型 ID 與推理強度放在設定檔。預算則用「每成功任務成本 × 月任務量 × 1.2–1.3」估算。
五、結語:把成本當成每月要重算的變數
模型每隔數週就可能換代,上一代剛成為預設,下一代已經更便宜。企業真正該建立的是可重跑的評估樣本集與成本監控,而不是記住某一個數字。GPT-6.1 Sol 的 0.72 美元是一個很好的提醒:該重新檢查預設模型與推理強度了。
需要協助建立成本評估與模型分層,歡迎參考優創智能的 AI 導入服務,或直接 與我們聯絡。
參考來源
- Artificial Analysis,〈GPT-6.1 Sol replaces GPT-6 Sol after just 7 days, with near-Astra intelligence〉,2026-09-29:https://artificialanalysis.ai/articles/gpt-6-1-sol-replaces-gpt-6-sol-after-just-7-days-with-near-astra-intelligence
- Artificial Analysis,〈GPT-6.1 Sol (max) 模型頁〉,2026-10-01 查閱:https://artificialanalysis.ai/models/gpt-6-1-sol
- Artificial Analysis,〈GPT-6 Sol (Max) vs GPT-5.6 Sol (Max)〉,2026-10-01 查閱:https://artificialanalysis.ai/models/comparisons/gpt-6-sol-vs-gpt-5-6-sol
相關推薦與延伸閱讀
- GPT-6.1 Sol 上線:接近 Astra 的能力、五分之一價格,企業 AI 代理該怎麼重新選型:OpenAI 發布 GPT-6.1 Sol,官方表示程式碼、電腦操作與專業文件任務接近 GPT-6 Astra,標準價僅 Astra 的五分之一:輸入 $2、快
- GPT-6 Sol 與 Luna 上線:API 降價 50%,企業 AI 導入該怎麼選模型與分層:OpenAI 於 2026 年 9 月 22 日發布 GPT-6 Sol 與 GPT-6 Luna,API 價格比 GPT-5.6 同級模型降低 50%,快取讀
- Claude Opus 5.5 上線:成本降 40%、長任務更穩,企業 AI 導入該怎麼評估與切換:Anthropic 於 2026 年 9 月 22 日發布 Claude Opus 5.5,官方表示預設設定下執行成本比 Opus 5 低約 40%,Token