文/Laban(優創智能 AI 導入工程師)
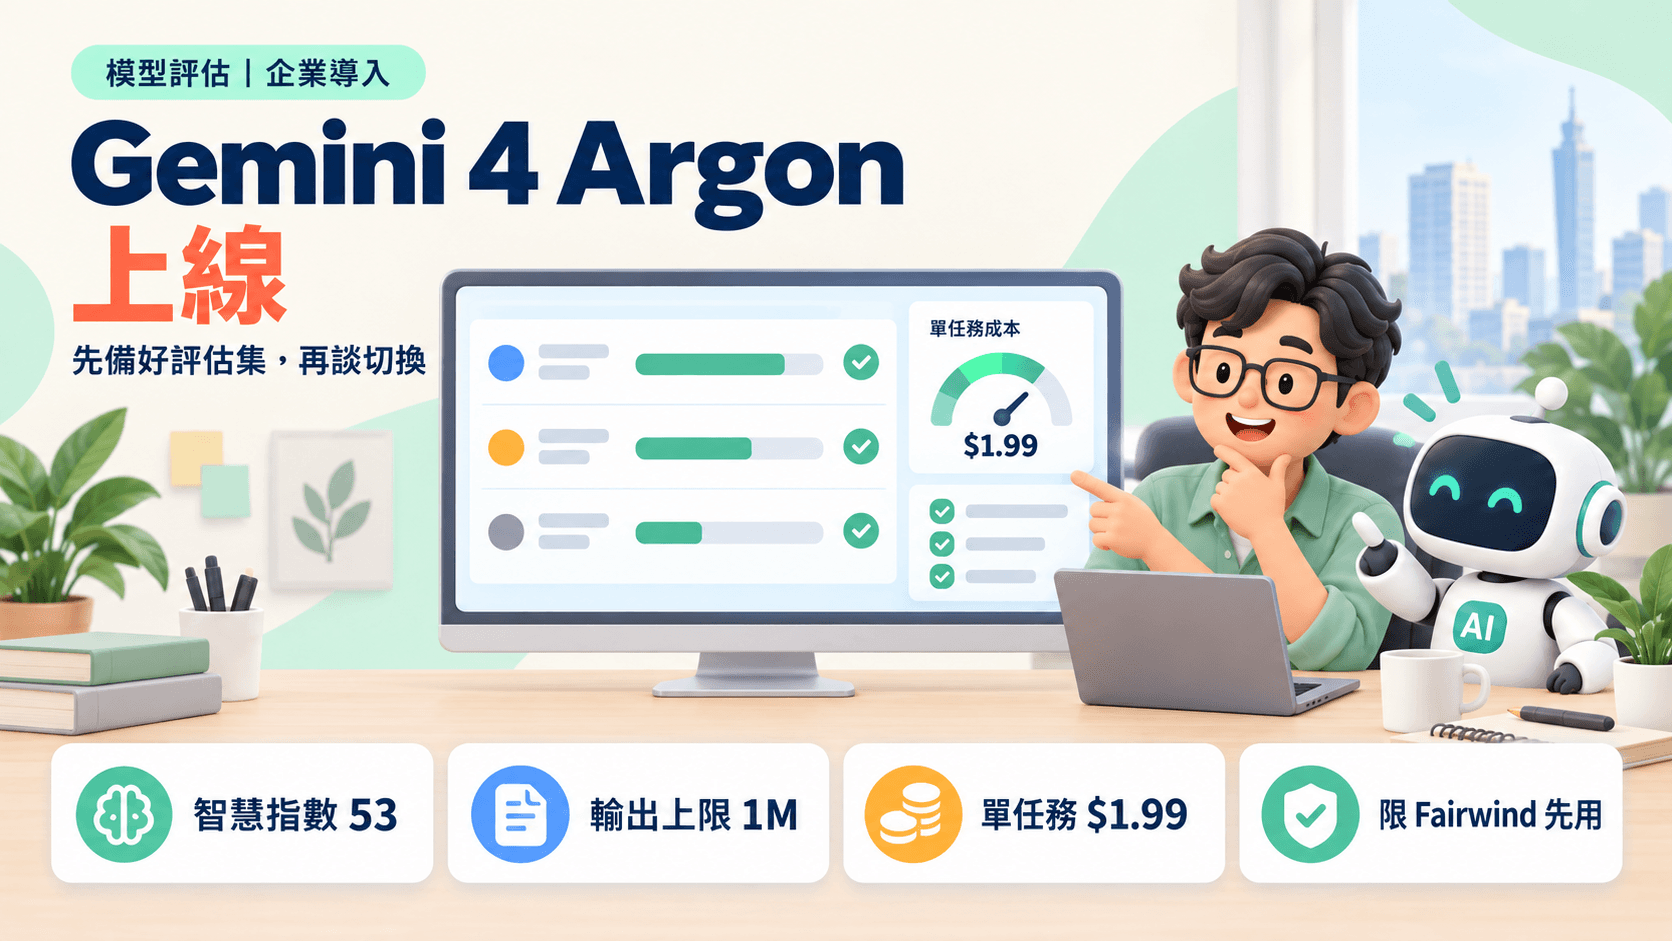
Gemini 4 Argon 是 Google 在 2026 年 9 月 30 日發布的前沿模型,主打長流程推理、軟體工程、法務財務等知識工作與資安防禦。結論先講:能力已追平 GPT-6 Astra,但台灣企業現在還用不到,而且優惠價結束後,單任務成本會比 Astra 還高。 現階段該做的是準備評估集,而不是排切換時程。
OpenAI 這一輪的模型與價格,可先看 GPT-6 Astra 上線:台灣企業導入前要看懂的 5 件事 與 GPT-6.1 Sol 上線:接近 Astra 的能力、五分之一價格;Google 目前可用的工作型模型,見 Gemini 3.8 Flash 評價。
一、Gemini 4 Argon 的五個關鍵事實
1. 上線範圍:目前只開放 Fairwind 計畫
Google 官方公告(2026-09-30)表示,Argon 先開放給 Fairwind 計畫(Fairwind Program)中的受信任資安防禦者,讓他們在模型全面開放前找出並修補自家軟體的漏洞。Google 也依美國政府的自願性上市前模型存取流程提供模型。
更大範圍的開放,官方只說「會盡快」,先從付費 API 客戶與 Google AI Ultra 訂閱者開始,沒有公布日期。也就是說,一般台灣企業目前無法透過 API 或 Gemini App 使用 Argon。
2. 價格:優惠價 $2/$10,之後回到 $4/$20
以下為官方公布的 API 價格(每百萬 Token):
| 項目 | 優惠價 | 標準價 |
|---|---|---|
| 輸入 | $2 | $4 |
| 快取輸入 | 比輸入價低 95%(優惠期間約 $0.10) | 比輸入價低 95% |
| 輸出 | $10 | $20 |
官方沒有說明優惠價會維持多久。作為對照,GPT-6 Astra 的標準價是輸入 $10、輸出 $50;只看價格表,Argon 的標準價約為 Astra 的四成。但價格表不等於實際成本,第二節會說明原因。
3. 輸出上限 1M Token
官方表示,Argon 的輸出上限從 64K 提高到 1M Token。上下文長度官方公告未寫明,Artificial Analysis 列為 1M Token。
輸出上限的意義是「一次能產出多長的內容」:長篇報告、大量程式碼或整份文件改寫,不必再拆成多次請求。但輸出越長,費用也越高,這點在代理任務中特別明顯。
4. 跑分:智慧指數 53,追平 Astra
獨立評測機構 Artificial Analysis 的結果:
- Intelligence Index:Argon(high 推理強度)為 53,與 GPT-6 Astra(max)相同,比 GPT-6.1 Sol(max)高 1 分;比 Gemini 3.1 Pro Preview 高 23 分,比 Gemini 3.8 Flash(high)高 12 分。
- AutomationBench-AA(多步驟業務流程):78%,比 Claude Sonnet 5.5(max)的 71% 高 7 個百分點。
- AA-Omniscience(知識正確性):幻覺率 15%,是所有得分 45 以上模型中最低;正確率 50%。
Google 官方公布的成績:
- DeepSWE v1.1(真實程式碼庫的軟體工程任務):77.9%
- AutomationBench:51.3%,排名第一
- CWE-bench v1(找出軟體弱點):68%,並列第一
- LVBench(長影片理解):91.7%
注意兩個容易混淆的地方:Google 公布的 AutomationBench 與 Artificial Analysis 的 AutomationBench-AA 是不同的評測,51.3% 和 78% 不能直接比較。另外,Argon 的 53 分是在 high 推理強度下取得,Astra 與 Sol 是 max,比較時要記得設定不同。
5. 安全:先給資安防禦者用
官方說明,Argon 能自主找出、驗證並修補關鍵軟體漏洞,這也是它先開放給資安防禦者的原因。9to5Google(2026-09-30)的報導指出,Fairwind 計畫中的受信任防禦者可以使用不含資安防護限制的版本。
安全措施方面,官方列出內外部紅隊測試、監控模型內部活動以偵測濫用、以思考鏈監控偏差行為,以及在沙箱環境中測試高風險能力。在 Gray Swan 的間接提示注入(IPI)評測中,Argon 的抗提示注入能力領先。對要讓 AI 讀外部文件、網頁或客戶訊息的企業,這項值得留意;防禦做法可參考 AI 客服的提示注入防禦。
二、單任務成本怎麼讀:優惠價便宜,標準價反而比 Astra 貴
Artificial Analysis 用 Intelligence Index 的評測任務,算出每個任務的平均成本:
| 模型(推理強度) | Intelligence Index | 單任務成本 |
|---|---|---|
| Gemini 4 Argon(high,優惠價) | 53 | $1.99 |
| Gemini 4 Argon(high,標準價) | 53 | $3.98 |
| GPT-6 Astra(max) | 53 | $3.26 |
| GPT-6.1 Sol(max) | 52 | $0.72 |
GPT-6.1 Sol 的數字取自 Artificial Analysis 先前的評測,詳見 GPT-6.1 Sol 單任務成本降到 0.72 美元。
三個重點:
- 優惠價下,Argon 約是 Astra 的 60%。這是新聞標題常引用的數字。
- 優惠結束後,Argon 比 Astra 貴約 22%。價格表上 Argon 便宜很多,實際卻更貴,原因是 Token 用量:Argon 每個任務平均輸出約 62k Token,Astra 約 27k,是兩倍多。
- GPT-6.1 Sol 只低 1 分,成本約是 Argon 優惠價的三分之一。如果你的任務 Sol 已經做得好,Argon 很難靠價格說服你換。
這些是 Artificial Analysis 自己的評測任務,不等於你公司任務的實際成本。但它說明了一件事:比較模型要看「每個成功任務花多少錢」,不是只看每百萬 Token 的單價。
三、跟 Astra、Sol、Flash 怎麼分工
| 模型 | 現在能不能用 | 建議角色 |
|---|---|---|
| GPT-6.1 Sol | 可以 | 企業預設模型,處理多數程式開發、文件與流程任務 |
| GPT-6 Astra | 可以 | 例外升級,只用在 Sol 做不好、且錯誤代價高的任務 |
| Gemini 3.8 Flash | 可以 | 大量、低成本的文件理解與工具串接任務 |
| Gemini 4 Argon | 尚未開放 | 開放後列入候選,優先驗證下列任務 |
依官方與第三方公布的成績,Argon 開放後值得優先驗證的任務有四類:
- 需要一次輸出很長內容的流程:長篇報告、大量程式碼生成,對應 1M 輸出上限。
- 長影片理解:例如會議錄影或教育訓練影片的摘要與檢索,對應 LVBench 成績。
- 程式碼弱點分析:對應 CWE-bench 成績與官方的資安定位。
- 答錯代價高的知識問答:對應較低的幻覺率。
這是「值得測」,不是「一定比較好」。跑分是在特定設定下取得,你的資料格式、系統介面與容錯標準都不同。
四、Argon 開放前,台灣企業可以先做的四個步驟
步驟 1:挑出可能受益的任務
從過去 30 天的 AI 使用紀錄,找出符合上一節四類的任務,並記下目前用哪個模型、哪個推理強度、平均輸入與輸出多少 Token。輸出 Token 特別重要,因為 Argon 的成本主要卡在這裡。
步驟 2:建立評估集,先記錄現行模型的基準
每類任務抽 30–50 題,包含過去失敗的案例,先用目前的模型跑一次,記錄四項指標:
- 輸出品質(人工評分或既有評分規則)
- 每個成功任務的總成本
- 回應延遲
- 輸出格式是否仍符合下游系統
Argon 開放後,只要用同一批題目再跑一次就能比較,不必臨時找資料。評估流程可參考 AI 導入 PoC 的 30/60/90 天評估。
步驟 3:用兩種價格各算一次預算
用優惠價與標準價各算一次月成本,公式是「每成功任務成本 × 月任務量」。決策時以標準價為準,因為官方沒說優惠會維持多久。如果標準價下的成本比現行模型高,品質的提升就要能換算成可量化的收益,例如減少的人工覆核時間。
步驟 4:把模型選擇放進路由設定
模型 ID 與推理強度放在設定檔,不寫死在程式碼中,Argon 開放時只要改設定就能以 10%–20% 流量灰度測試,出問題可立即退回。多模型分流的做法可參考 用 Jev 做模型路由與成本控管;若要讓 Argon 執行程式碼或操作系統,同時要限制它能碰的範圍,見 AI 代理權限邊界與沙箱設計。
五、結語:Google 回到前三,企業的選項多了一個
Artificial Analysis 的評語是 Google 重回智慧程度前三大實驗室。對企業來說,這代表前沿級模型多了一家供應商可選,議價與備援空間都變大。但 Argon 目前用不到、優惠價期限不明、Token 用量偏高,這三點都讓「現在就規劃切換」不實際。
比較好的做法是把評估集準備好、把模型設定抽出來。下一個模型發布時,無論是不是 Argon,你都能在一週內用自己的數據做決定。
如果你的團隊正在評估多模型分層或規劃 AI 代理,歡迎參考優創智能的 AI 導入服務,或直接 與我們聯絡。
說明
模型能力、開放範圍與價格可能隨時變動;第三方評測的版本與方法也會更新。本文依官方公告與獨立評測提出實務判斷,不代表任何模型在所有任務中都有相同表現,也不是 Google 或任何評測機構的官方背書。
參考來源
- Google,〈Gemini 4 Argon: our next era of frontier intelligence〉,2026-09-30:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon/
- Artificial Analysis,〈Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved〉,2026-10-02 查閱:https://artificialanalysis.ai/articles/gemini-4-argon-google-top-three-labs
- 9to5Google,〈Google announces Gemini 4 Argon as its new frontier model〉,2026-09-30:https://9to5google.com/2026/09/30/gemini-4-argon-announcement/
- Engadget,〈Google's first Gemini 4 model is 'Argon'〉,2026-09-30:https://www.engadget.com/2274263/google-gemini-4-model-argon/
相關推薦與延伸閱讀
- GPT-6.1 Sol 上線:接近 Astra 的能力、五分之一價格,企業 AI 代理該怎麼重新選型:OpenAI 發布 GPT-6.1 Sol,官方表示程式碼、電腦操作與專業文件任務接近 GPT-6 Astra,標準價僅 Astra 的五分之一:輸入 $2、快
- Claude Opus 5.5 上線:成本降 40%、長任務更穩,企業 AI 導入該怎麼評估與切換:Anthropic 於 2026 年 9 月 22 日發布 Claude Opus 5.5,官方表示預設設定下執行成本比 Opus 5 低約 40%,Token
- GPT-6.1 Sol 單任務成本降到 0.72 美元:Artificial Analysis 評測怎麼讀,企業重算 AI 代理成本的四步驟:Artificial Analysis 評測顯示 GPT-6.1 Sol 單任務成本為 0.72 美元,比 GPT-6 Sol 低約 31%、比 GPT-5.6