文/TED|優創執行長
AI 能力宣稱幾乎每週都有。問題不在於這些消息是真是假,而在於媒體標題與原始來源之間常有落差,而企業主可能拿著標題去做決策。
這篇不講某個模型多強,講一個更實用的技能:看到「AI 突破」時,怎麼在十五分鐘內確認自己理解的是不是事實。我用 2026 年 9 月一則實際報導當教材。
這則新聞長什麼樣
2026 年 9 月 20 日前後,多家中英文科技媒體報導:OpenAI 的 GPT-6 Astra 與三位人類研究員合作,攻克了 FrontierMath 基準中一道自 2017 年起未解的「Major advance」等級開放數學問題。部分中文標題的措辭是「數學家淪為提示詞工具人」。
聽起來很清楚。但照著查證步驟走一遍,會發現需要補充的地方不少。
步驟一:找到一手來源
第一個動作永遠是:這個判定是誰做的?他們自己的頁面怎麼寫?
FrontierMath 由 Epoch AI 建立與維護,Open Problems 子集的狀態公布在 Epoch AI 自己的網站上。
查到的結果是:該頁面的統計顯示 Major advance 等級為 0/6 SOLVED,而 changelog 最新一筆更新停在 2026 年 8 月 12 日,內容是另一道題目(Hadamard matrix of order 668),且註明由 Anthropic 研究員回報、由三位人類與 Claude 共同完成,並標記為暫定判定。
換句話說,在我查證的當下,官方頁面尚未反映媒體報導的那項判定。這不代表報導是假的——可能是官方更新有時間差,也可能是判定仍在確認中。但它代表一件事:如果你要根據這則消息做決策,你引用的依據目前只有二手報導。
步驟二:看判定機構自己的標準
這一步最常被略過,卻最關鍵。
Epoch AI 在 changelog 中寫下了他們的判定原則,而且有個現成的對照案例。2026 年 8 月 11 日,關於 Mathieu Group M23 的反 Galois 問題,他們的判定是「由人類解決」,理由寫得很明白:
他們對「由 AI 解決」設有高門檻,要求解法的核心想法必須無疑義地由 AI 貢獻。在該案例中,一位作者表示「人類與 AI 貢獻的推理界線並不清楚,實務上大概不可能劃出明確分界」,另一位作者的紀錄則提到「其中一些最重要的決定,明顯是人類合作者做出的數學判斷」。基於這些描述,Epoch 認為無法確認核心想法由 AI 貢獻,因此不計為 AI 解決。
這段話的意義是:同一件事,在寬鬆標準下是「AI 解決了問題」,在 Epoch 的標準下是「人類解決了問題」。差別不在事實,在判準。
所以當你看到「AI 攻克某問題」時,真正該問的是:誰認定的?他們的標準是什麼?這個標準和我關心的事情有關係嗎?
步驟三:確認人類參與程度
回到那則報導。即使照報導本身的描述,過程也是一個模型加三位人類研究員的互動式協作,而非模型獨立完成。
「數學家淪為提示詞工具人」這類措辭,會讓讀者形成「人類已無關緊要」的印象。但從 Epoch 對 M23 案例的處理可以看出,專業數學家在這類協作中的判斷,往往是決定性的。
這件事對企業導入的直接啟示是:目前最有效的模式是人機協作,不是人被取代。如果你根據「AI 已經可以獨立完成專業工作」這個前提去規劃人力,前提本身就站不住。
步驟四:分辨「能力存在」與「你能用到」
最後一步,也是對預算影響最大的一步。
即使某項能力確實存在,還要問三個問題:
這個能力目前可以取得嗎? 研究展示、內部模型與公開 API 是三件不同的事。 它適用於我的任務嗎? 數學推理表現好,不代表處理你的報價單或客訴分類同樣好。 成本是多少? 需要大量互動與專家投入才能達成的結果,複製到企業場景的成本可能遠高於預期。
補充一個相關事實:Epoch AI 在同一頁面說明,目前只有 OpenAI 購買了該基準的驗證程式存取權。這不影響判定的效力,但說明了基準測試的生態本身也有值得了解的結構。
一份可以直接用的查證清單
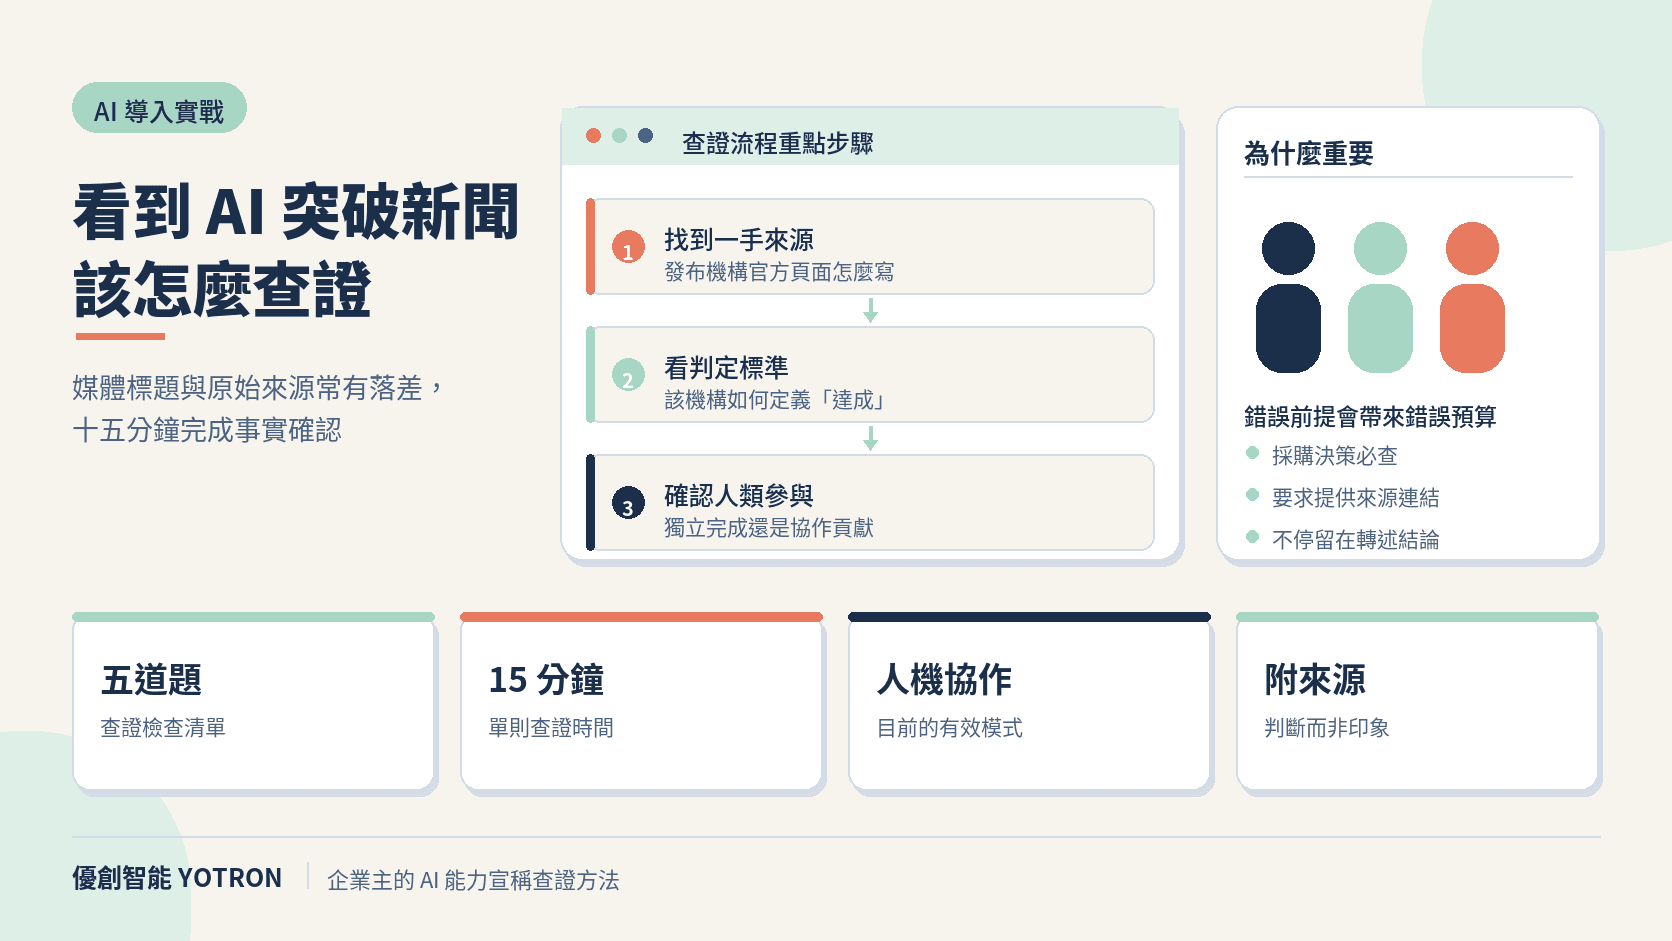
看到 AI 能力宣稱時,依序問這五題:
- 一手來源在哪裡? 找到發布或判定機構的官方頁面,不停在轉述。
- 判定標準是什麼? 該機構如何定義「達成」?有沒有對照案例?
- 人類參與多少? 是獨立完成,還是協作?協作中誰做關鍵判斷?
- 我現在能用到嗎? 研究成果、內部模型、公開服務是三件事。
- 和我的任務有關嗎? 基準任務與你的實際工作有多少重疊?
五題走完通常不超過十五分鐘。這十五分鐘的價值,在於它會擋掉基於錯誤前提的決策。
為什麼我把這件事看得比新聞本身重要
我們接觸過不少公司,導入失敗的原因不是工具選錯,是一開始的預期就建立在不準確的資訊上。老闆看到某則報導,認定某件事已經可以自動化,於是編了預算、設了時程;實際做下去才發現,報導描述的情境和公司的實際條件差距很大。
這不是誰的錯。資訊流動的速度遠快於查證的速度,而多數企業主沒有時間逐則確認。
所以我的建議是:不必每則都查,但涉及採購決策或對外承諾的,一定要查。這類宣稱通常一個月不會超過兩三則,花不了多少時間。
如果要授權給同仁或顧問處理,請要求對方提供來源連結,而不是只給結論。能不能拿出來源,通常就能分辨出是查過的判斷還是轉述的印象。
參考來源
- Epoch AI, "FrontierMath: Open Problems" 專案頁面與 changelog(查證時間:2026-09-21)
- Epoch AI changelog 2026-08-11 關於 Mathieu Group M23 判定為人類解決之說明
- Epoch AI changelog 2026-08-12 關於 Hadamard matrix of order 668 之暫定判定說明
本文引用之基準狀態以查證當日的官方頁面為準;該頁面持續更新,讀者引用前建議重新確認。
相關推薦與延伸閱讀
- AI Agent 的權限邊界怎麼設:企業導入前必須畫好的三條線:企業導入 AI Agent 前,權限邊界比模型選型更該先決定。本文用 2026 年 OpenAI–Hugging Face 事件與 Google Gemini
- AI 導入顧問怎麼選?台灣中小企業比較顧問與 DIY 的成本、風險與時程:要自己摸索 AI 工具,還是請顧問協助?本文分析兩種方式的成本、風險與適用情境,幫台灣中小企業老闆做出適合自己的決定。
- AI 導入效果不佳?企業應檢查的 5 個原因與改善方法:AI 工具買了沒人用,先檢查需求、導入範圍、操作支援、繁體中文品質與維護能力。用實際紀錄找原因,再決定調整、延長試行或停止。