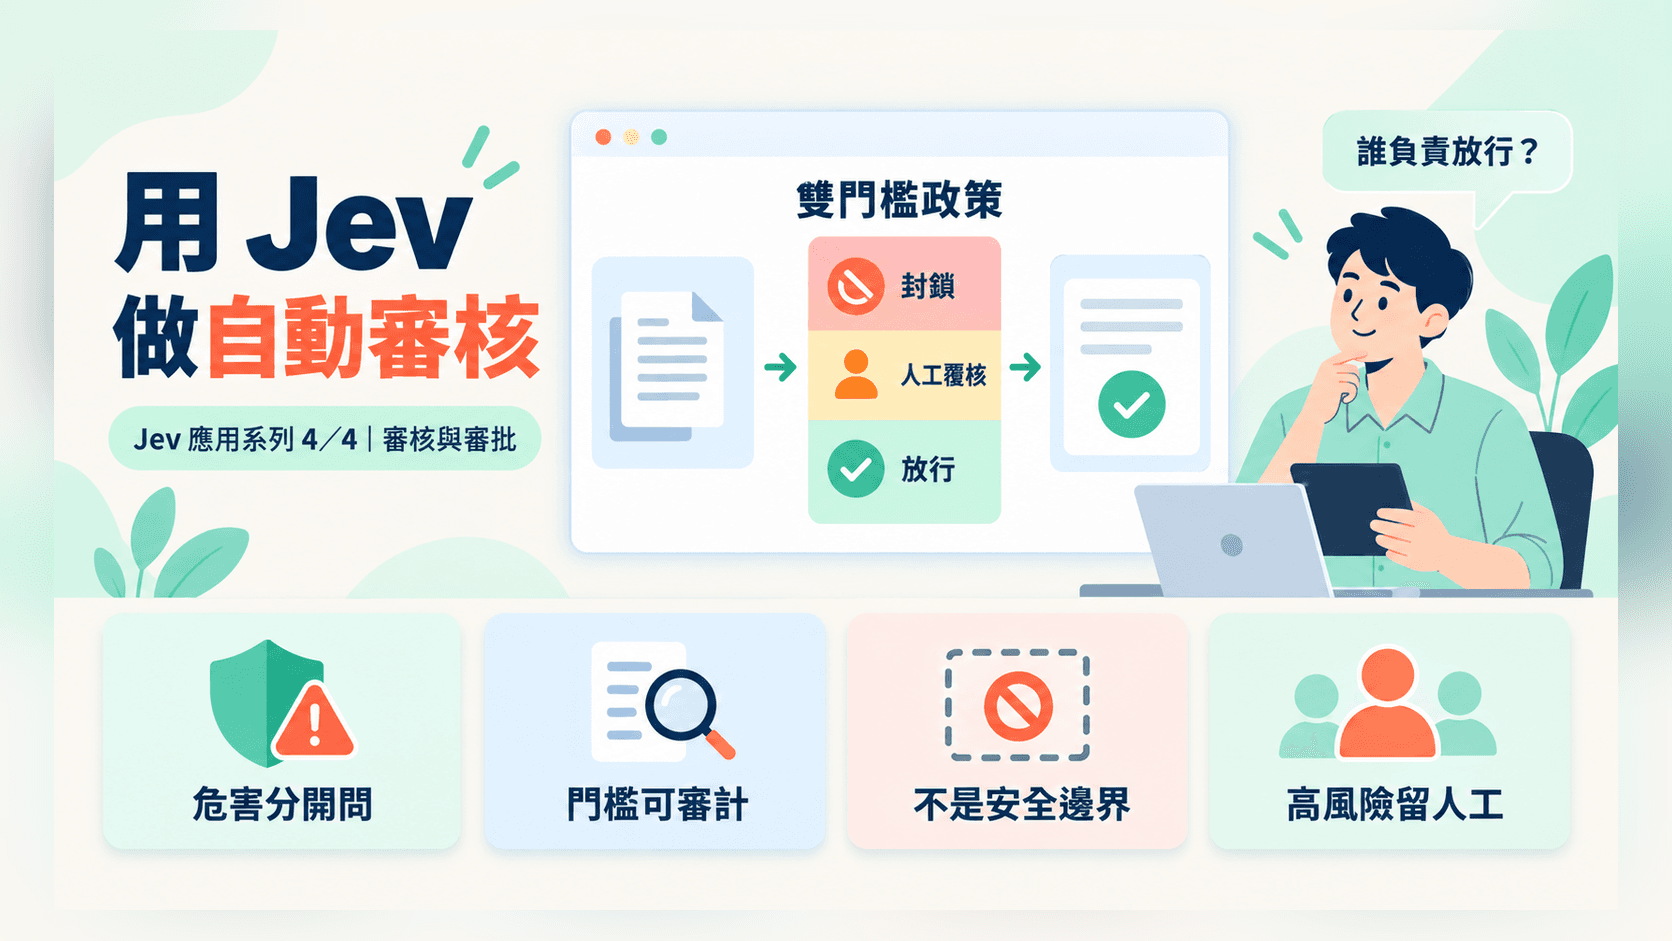
自動審核的難處從來不是判斷一則訊息有沒有危害,而是把那個判斷變成企業敢負責的決策 — 誰放行、誰覆核、誰封鎖、事後怎麼查。Jev 在這件事上的貢獻是把危害拆成多個窄問題並回傳校準機率,讓門檻與處置規則變成可以 code review 的常數。結論先說:這讓審核流程變得可審計,但 Jev 本身不能當安全邊界,官方文件對此說得很清楚。
社群開發者 Sac 在 2026-09-18 的貼文中把「自動審核」列為 Jev 的四個場景之一,並稱它是「比 5.6 luna 還要便宜且精準的自動審核模型,可能是 Codex 在安全審批方面最合適的工具」。Sac(@Saccc_c)X 貼文,2026-09-18 「更精準」目前沒有公開的獨立 benchmark 支持,本文把它視為使用體感;可查證的部分是官方的定價、問題設計方式與已知失效模式。
一個安全分數撐不起企業流程
多數團隊的第一版審核長這樣:問模型「這則內容是否違規」,拿到一個 0 到 1 的分數,超過某個值就擋掉。這個設計在企業流程裡會壞在三個地方。
第一,不同危害需要不同處置。疑似越獄應該封鎖;請求醫療建議應該轉人工覆核;自傷訊號應該導向支援管道而不是丟掉。一個籠統分數無法區分。第二,一個分數無法回答稽核問題。事後被問「為什麼擋這則」,你只能回答「分數 0.82」。第三,門檻無法分別調整。放寬越獄門檻會同時放寬所有危害。
官方 guardrails cookbook 的做法是把危害拆開:四個 Noul 問題各問一個危害類型(是否試圖越獄或洩漏指令、是否請求協助造成傷害或違法、是否要求診斷或用藥劑量、是否顯示自傷傾向),再加一個 Score 問題評估「若照做會造成多大危害」,從無害到嚴重人身傷害共四級。TypeSafe Docs〈Guardrails for LLMs〉,查閱 2026-09-18
進出兩側問同一組問題的兩個方向:輸入側問使用者是否在要求,輸出側問回覆是否真的照做了。一次請求就能拿到整組訊號。
雙門檻加政策:把取捨變成產品決策
官方把危害機率對應到兩個門檻與一組動作映射:
HAZARD_ACTION = {
    "jailbreak": "block",
    "broke_policy": "block",
    "harmful_request": "block",
    "medical_advice": "review",   # 轉人工覆核,不直接封鎖
    "self_harm": "support",       # 導向支援管道,不封鎖
}
PRECEDENCE = ["support", "block", "review", "pass"]   # 優先序高者勝

POLICIES = {
    "strict":     {"review_threshold": 0.35, "action_threshold": 0.70, "severity_block": 2.0},
    "permissive": {"review_threshold": 0.35, "action_threshold": 0.85, "severity_block": 2.0},
}
判斷邏輯是:達到 action_threshold 觸發該危害對應的動作,達到較低的 review_threshold 轉人工,兩者都未達到則放行;嚴重度 Score 達到 severity_block 時,把原本的人工覆核升級為封鎖。
def route(nouls: dict[str, float], severity: float, policy: dict) -> str:
    triggered = []
    for hazard, probability in nouls.items():
        if probability >= policy["action_threshold"]:
            triggered.append(HAZARD_ACTION[hazard])
        elif probability >= policy["review_threshold"]:
            triggered.append("review")
    if severity >= policy["severity_block"]:
        triggered = ["block" if a == "review" else a for a in triggered]
    return next((a for a in PRECEDENCE if a in triggered), "pass")
這段程式碼的價值不在演算法,在治理。官方對 policy 的說明重點是:把這些數字命名之後,寬鬆與嚴格就成為產品可以選擇的設定,而不是繼承下來的預設值。對企業而言這意味著三件事可以落地 — 門檻進 code review、不同產品線套不同 policy、稽核時能指出是哪一個危害、哪一個門檻、哪一條優先序做了決定。
PRECEDENCE 的順序本身也是政策宣告:support 排在 block 之前,代表一則同時觸發自傷訊號與其他危害的訊息會被導向支援管道,而不是被靜靜擋掉。
Jev 不是安全邊界
這是整篇文章最重要的一段。官方 jaggedness 文件的原文重點是:state 是資料,jev-1.13 預設不把它視為敵意內容;刻意誘導模型的內容 — 注入指令、誤導性框架、替自己的分類辯護的文字 — 都可能移動答案。官方表示未來會改善,並建議在 criteria 裡寫明確、部署前充分測試邊界案例。TypeSafe Docs〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17
換句話說,審核模型本身就是被審核內容可以攻擊的對象。這代表:
- 不可逆動作不能只靠審核通過。付款、退款、權限提升、對外發文仍需明確授權、業務規則、最小權限與人工批准。審核只提供一個可供稽核的訊號。
- 審核結果要記錄,不只記結論。保留每個危害的機率、套用的 policy 名稱與觸發的門檻,否則無法在事後區分「模型判錯」與「門檻設錯」。
- 審核層需要自己的測試集。官方建議部署前測試邊界案例;這組測試應該包含刻意設計的注入樣本,並且隨新出現的攻擊手法更新。
若審核的對象是 coding agent 的操作(例如 Codex 的安全審批),還要多一層認知:被讀進來的 issue 內文、依賴套件說明、程式註解都是 state,都可能夾帶指令。相關的防護思路可參考AI 客服的 Prompt Injection 防禦。
繁體中文審核的準確度風險
官方 Models 頁面說明 Jev 的主要訓練語言是英文,準確度在英文最好;CJK 文字包含繁體中文可以處理但目前準確度較低,建議在自己的內容上先測試,並在路由時特別留意 confidence。TypeSafe Docs〈Models〉,查閱 2026-09-18
審核場景的誤判成本是不對稱的,而且方向與模型路由相反:漏判(把有害內容放行)的代價遠高於誤判(把正常內容送人工)。因此中文流程的合理調整方向是把 review_threshold 調低、接受較高的人工覆核量,直到你在自己的中文樣本上量出可接受的漏判率。不要把官方英文範例的 0.35 與 0.70 直接搬到中文上線。
另外注意官方對結構不變性的提醒:同一個問題用 Noul 與用 yes/no Choice 問,數值不可互換,也不要期待一個問題與其否句的機率相加為 1。審核門檻必須綁定問題型別與模型版本,換版本要重新校準。
導入前的四步驗證
步驟 1:先寫政策,再寫問題
把「哪些內容必須封鎖、哪些必須轉人工、哪些導向支援」寫成文字政策並取得業務與法務確認,再把每一條翻成一個窄問題。順序顛倒的話,你會得到一組技術上可跑、但沒人願意簽名負責的門檻。
步驟 2:建立含攻擊樣本的標記集
抽真實訊息,加上刻意設計的注入與誘導樣本,由熟悉政策的人標記應有處置。分開統計漏判率與誤判率 — 兩者的合理上限不同,不該用單一準確率概括。
步驟 3:掃門檻,選定 policy
把 review_threshold 與 action_threshold 掃過一遍,每組設定記錄漏判率、誤判率、人工覆核量與每則成本。選定的組合要能同時滿足「漏判率可接受」與「人工覆核量負擔得起」,並記錄選擇理由。人工負荷的估算方式可參考AI 導入的員工採用與變革管理。
步驟 4:影子上線,保留人工否決權
先讓審核只記錄不生效,比對影子決策與現行人工判斷的差異。正式上線後,人工必須能否決任何自動處置,並且該否決要回饋成新的標記資料。需要協助把政策翻成可驗收的門檻設計時,可聯絡優創智能。
結論:可審計的門檻,勝過更準的分數
Jev 在自動審核上的真正貢獻不是「更準」— 那一點目前沒有公開 benchmark 可以證明。它的貢獻是讓審核流程的每一個決定都有名字:哪一個危害、哪一個機率、哪一個門檻、哪一條優先序、哪一份 policy。這是企業敢把審核自動化的前提。
同時要記住官方自己講明的邊界:state 不被預設為敵意內容,審核模型可以被它審的內容影響。因此合理的架構是「Jev 提供可量測的風險訊號 + 程式規則決定處置 + 高風險動作保留人工批准」,而不是把審核模型當成安全邊界。先寫政策,再量漏判率,最後才談自動化比例。
來源與查閱日期
- Sac(@Saccc_c),Jev 四大應用場景貼文,2026-09-18。X 貼文
- TypeSafe Docs,〈Guardrails for LLMs〉(危害問題組、雙門檻、policy 設計),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Jev 1.13 jaggedness〉(adversarial content、結構不變性),最後檢閱 2026-09-17,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Models〉(價格、語言支援),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Confidence〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Noul〉,查閱 2026-09-18。官方文件
相關推薦與延伸閱讀
- 用 Jev 做模型路由:便宜模型先跑、Jev 驗證、只在需要時升級:模型路由的省錢關鍵不是挑便宜模型,而是知道什麼時候必須升級。本文拆解 TypeSafe 官方的 verify-then-escalate cascade、該怎麼
- 企業 AI Agent 進入 production:FDE 如何建立控制平面:從近期企業 AI 平台與研究訊號整理一套 FDE 實作方法:把 Agent 的身分、工具、政策、評估與觀測整合成可驗收的控制平面。
- 企業 AI Agent 上線前的 FDE 驗收清單:從 Demo 走到可治理工作流:常青實務指南:用 FDE 方法檢查企業 AI Agent 的流程、資料、權限、評估、觀測與交接,降低從 POC 進入正式營運的風險。