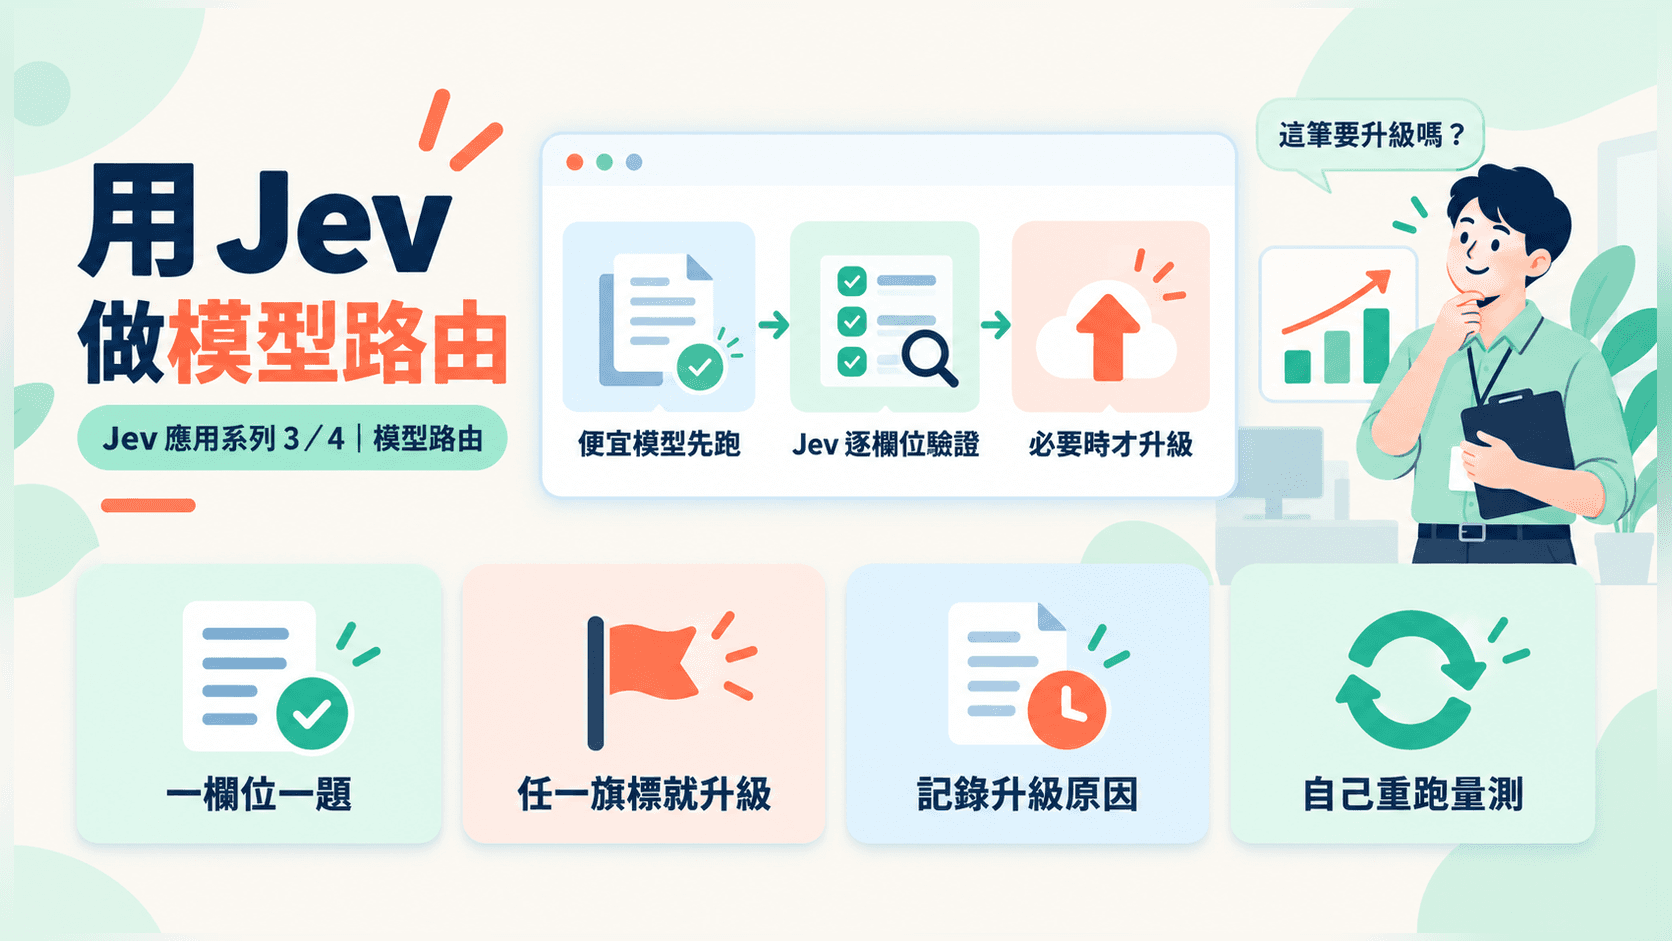
模型路由真正省錢的地方不是挑到便宜模型,而是知道什麼時候必須升級。官方 TypeSafe 的做法是 verify-then-escalate:便宜模型先產出結果,Jev 針對每個欄位問一題「這個值是不是錯的」,只有旗標燒起來的案例才付貴模型的錢。結論先說,這個架構在官方內部測試中讓成本/品質前緣優於任何單一模型,但公布的數字是 TypeSafe 自己在 100 個 prompt 上的歷史快照,你必須用自己的任務重跑。
社群開發者 Sac 在 2026-09-18 的貼文中把「模型路由」列為 Jev 值得試的四個場景之一,描述為「根據任務複雜程度自動分配合適的模型來處理」。Sac(@Saccc_c)X 貼文,2026-09-18 依任務難度分配是官方文件中的 intent routing 模式;但官方另有一個效果通常更好的模式,本文把兩者並列比較。
兩種路由:猜難度,還是檢查結果
Intent routing 是先判斷再分配。官方範例對客服訊息同時問意圖(Choice)與複雜度(Score),再依結果決定走純程式邏輯、走某個專用 LLM,還是轉人工;意圖 confidence 低於 0.5 一律轉人。TypeSafe Docs〈Intent routing〉,查閱 2026-09-18
這個模式的限制在於它猜的是難度,而難度與模型會不會出錯並非同一件事。一個「簡單」的抽取任務仍可能讓便宜模型產生 schema 合法但內容錯誤的輸出。
Cascade 是先跑再檢查。官方 SDE cascade cookbook 的流程是 extract → verify → escalate:先用 mini 模型抽取,再用 Jev 對每個欄位問一題驗證問題,任一旗標超過門檻才升級到 reasoning 模型。TypeSafe Docs〈SDE cascade〉,查閱 2026-09-18
該 cookbook 的示範案例點出了關鍵差異:mini 模型輸出了一個完全符合 JSON Schema、卻是憑空編出來的 description 欄位。文件的原話重點是 schema 驗證必要但不充分 — 它抓結構錯誤,永遠抓不到語意錯誤。驗證層要補的正是這一段。
官方公布的數字與它的邊界
官方在 100 個 scrapegraphai prompt 上跑了同一套 extract → verify → escalate 流程,模型組合為 gpt-5.4-mini → gpt-5.5-reasoning,閘門門檻從 0 掃到 1,把每個設定畫在(成本,品質)平面上。結果是:
- 最強的單一模型
gpt-5.5-reasoning約在每次抽取 0.10 美元、品質約 0.81 的位置。 - cascade 的 pareto 前緣位於所有單一模型的左上方,也就是以較低成本取得接近最強模型的品質。
官方對這組數字加了兩個限制,引用時必須一起帶上:這是 TypeSafe 的內部結果,而且該圖是歷史快照,其成本未依現行 Jev 價格重新計算。因此它能證明的是方法有效,不能當成你的預期節省幅度。
實作:驗證層與升級閘門
驗證問題的寫法決定整個架構的效果。官方建議每題只檢查一個欄位、對照來源、可用是非回答:
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()
FIRE_T = 0.7   # 任一欄位旗標超過此值就升級;常數集中管理,綁定模型版本

def verify(source: str, record: dict) -> dict[str, float]:
    """對便宜模型的輸出逐欄位提問,回傳每個欄位的錯誤機率。"""
    state = {"source": source, "extracted": record}
    questions = {}
    for field in record:
        questions[f"{field}::hallucinated"] = Noul(
            instructions=(
                f"extracted['{field}'] states something that does not appear in source."
            ),
        )
        questions[f"{field}::off_target"] = Noul(
            instructions=(
                f"extracted['{field}'] answers a different question than the field name asks."
            ),
        )
    answers = client.system_one(state=state, questions=questions).answers
    return {qid: answers[qid].noul for qid in questions}
閘門用 max 式判斷,不取平均。官方明確說明這是為了讓單一個高信心紅旗足以觸發升級,而不是被其他正常欄位平均掉:
def route(source: str, record: dict) -> dict:
    flags = verify(source, record)
    fired = {qid: p for qid, p in flags.items() if p > FIRE_T}

    if not fired:
        return record                                  # 接受便宜模型的結果

    log_escalation(fired)                              # 留下升級原因
    return extract_with_reasoning_model(source)        # 只在這裡付貴模型的錢
log_escalation 不是可選項。升級率與升級原因是這個架構唯一能持續監控的健康指標:升級率突然上升代表上游資料或便宜模型行為改變了,而不是路由壞了。
三個會讓路由失效的設計錯誤
官方 jaggedness 文件列出的失效模式中,有三項直接打中驗證層。TypeSafe Docs〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17
- 把數值比較交給模型。驗證欄位時很容易寫出「這個金額是否與來源一致」這種問題,但 Jev 讀日期與數字如同文字,數值比較不可靠。金額、數量、日期先後一律在程式裡比對;模型只回答語意問題,例如「這個描述是否來自來源」。
- 一題塞多個判斷。「這個欄位是否正確」太寬,官方建議拆成窄而可查核的是非題。細粒度的好處在 cookbook 的示範裡很明顯:旗標集中在真正錯的那個欄位上,正確欄位維持低分。
- 把門檻跨型別搬運。官方說明同一個問題用 Noul 與用 yes/no Choice 得到的數值不可直接比較,也不要期待一個問題與它的否句機率相加為 1。
FIRE_T必須綁定問題型別與模型版本。
台灣企業的兩個額外變數
繁體中文準確度。官方 Models 頁面說明 Jev 的主要訓練語言是英文,CJK 文字包含繁體中文可處理但準確度較低,建議在自己的內容上先測試並留意 confidence。TypeSafe Docs〈Models〉,查閱 2026-09-18 驗證層誤判的成本是不對稱的:漏判會讓錯誤結果直接流進下游,誤判只是多花一次貴模型的錢。中文流程若準確度不足,應把 FIRE_T 調低,接受較高升級率。
rate limit 可能變動。jev-1.13.0 的公告限制為每秒 250,000 tokens、每分鐘 1,200 requests,但官方明說在高需求期間可能未經通知調整,穩定上限需走 custom 或 enterprise 方案。驗證層若成為所有請求的必經路徑,429 的退避與重試就是你整條流程的延遲上限,必須在設計時就算進去。
導入前的四步量測
步驟 1:先算出「錯誤的代價」
升級閘門的門檻由誤判成本決定,不是由準確率決定。先量清楚一筆錯誤結果流進下游要花多少錢修(人工更正、客戶溝通、資料回補),以及一次多餘升級要多花多少錢。兩個數字的比例就是門檻的起點。成本拆解方式可參考AI 導入成本怎麼算。
步驟 2:用人工標記建立真值
抽 100 筆真實案例,由熟悉業務的人標記便宜模型的輸出是對是錯,保留判斷理由與分歧案例。不要用另一個模型的平均預測當真值 — 那只能測一致性,不能測正確性。
步驟 3:掃門檻,畫出你自己的前緣
把 FIRE_T 從低到高掃一遍,每個設定記錄:升級率、最終準確率、每筆平均成本、p95 延遲。你要的不是官方那張圖,是你自己任務上的那張圖。若某個門檻同時給出可接受的準確率與明顯較低的成本,那就是候選上線設定。
步驟 4:影子上線,監控升級率
先讓路由只記錄不生效,比較影子決策與正式流程的差異。正式上線後把升級率設成告警指標,並保留「全部走貴模型」的一鍵回滾。需要協助設計這組量測時,可聯絡優創智能。
結論:路由的價值在閘門,不在便宜模型
把工作丟給便宜模型很容易,難的是知道什麼時候不能相信它。Jev 在這個架構裡扮演的不是省錢的模型,而是一個細粒度、可設門檻、output 免費的檢查層 — 它讓「便宜模型先跑」這件事變得可控。
值得帶走的判準有三個:驗證問題要窄到能指出是哪個欄位錯、閘門要用 max 而非平均、門檻要由誤判成本決定並綁定模型版本。官方公布的 0.10 美元與 0.81 品質是方法示範,你自己的那張成本/品質圖才是決策依據。
來源與查閱日期
- Sac(@Saccc_c),Jev 四大應用場景貼文,2026-09-18。X 貼文
- TypeSafe Docs,〈SDE cascade〉(extract → verify → escalate、100 prompt 內部結果),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Intent routing〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Confidence-gated routing〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Models〉(價格、rate limit、語言支援),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17,查閱 2026-09-18。官方文件
相關推薦與延伸閱讀
- 用 Jev 做自動審核:把「放行、覆核、封鎖」寫成可審計的門檻,而不是模型的心情:自動審核的難處不是判斷危害,是把判斷變成企業敢負責的決策。本文拆解 TypeSafe 官方 guardrails 的雙門檻政策設計、為什麼 Jev 不能當安全邊
- Gemini 3.8 Flash 值得推薦嗎?企業導入前的實用評估指南:Gemini 3.8 Flash 適合哪些企業工作?本文整理官方支援能力、適用情境與限制,協助台灣中小企業判斷是否值得導入。
- GPT-6 Astra 上線:OpenAI 新旗艦模型,台灣企業導入前要看懂的 5 件事:OpenAI 於 2026 年 9 月 3 日發表 GPT-6 Astra:105 萬 token 上下文、電腦操作能力、每百萬 token 10/50 美元。