文/Laban(優創智能 AI 導入工程師)
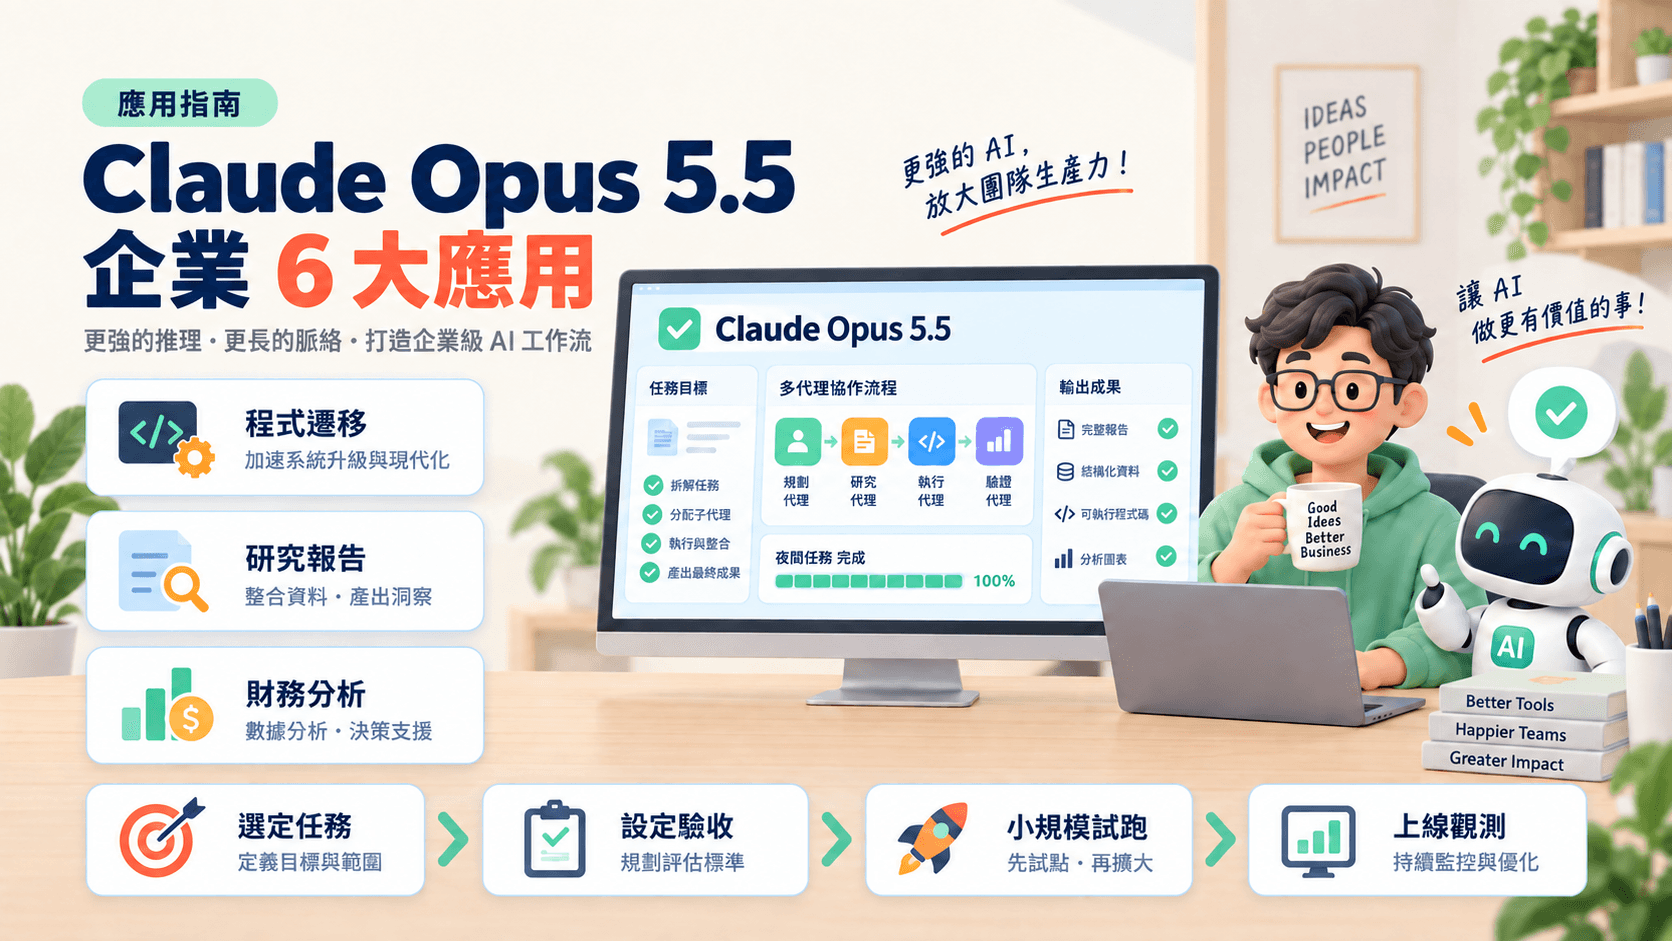
Claude Opus 5.5 是 Anthropic 於 2026 年 9 月 22 日發布的旗艦大型語言模型,強項是長時間、多步驟、需要自我檢查的代理任務。結論先講:企業最值得先交給 Opus 5.5 的,不是一問一答的聊天,而是「以前要一個團隊花幾週、現在可以排在下班後跑完再驗收」的工作。本文依官方公告與早期測試企業的實測回饋,整理 6 個應用情境、使用限制,以及挑選第一個應用的步驟。
價格、跑分與模型切換評估,我們已在〈Claude Opus 5.5 上線:成本降 40%、長任務更穩,企業 AI 導入該怎麼評估與切換〉整理過;本篇專注在「拿來做什麼」。
一、先看能力輪廓:Opus 5.5 強在哪裡
以下事實整理自 Anthropic 官方公告(2026-09-22):
- 長任務效率:完成同一任務使用的 Tokens 較少,典型工作負載成本比 Opus 5 低約 40%,輸出速度快 30% 以上。
- 委派與自我驗證:早期測試者指出它把工作分派給子代理(Subagent)的效果更好,也更容易建立自我檢查迴圈。
- 行為邊界:官方表示它比近期模型更不容易執行難以復原的操作,也更能抵抗提示注入(Prompt Injection)。
- 溝通方式:把最重要的資訊放在前面,較少術語,也更會遵守你給的寫作規則,長時間協作時比較容易檢查它做了什麼。
這四點決定了它的適用範圍:工作越長、步驟越多、越需要事後檢查,Opus 5.5 的優勢越明顯。
二、企業 6 大應用情境
以下每個情境都附上官方公告中的實測案例。案例來自海外企業的早期測試,數字代表該企業的特定任務,不能直接套用到你的環境,但足以說明「哪一類工作值得試」。
應用 1:大型程式遷移與程式碼稽核
適合誰:有舊系統要升級、要換語言或框架、技術債累積多年的團隊。
- 一位早期測試者用不到一天完成 68 萬行的程式遷移,官方估計這原本需要一個工程團隊花數週。
- 另一位測試者用 Opus 5.5 在 3 小時內稽核並修正 20 萬行程式碼;Opus 5 花了 20 小時以上,使用的 Tokens 是 2.5 倍。
- 官方內部測試把開源負載平衡軟體 HAProxy 從 C 改寫成 Rust,幾乎通過 HAProxy 全部既有回歸測試,耗時 9.5 小時,成本比 Fable 5.1 低 51%。
導入重點:遷移成敗取決於既有測試。沒有回歸測試的系統,應先讓模型補測試、由工程師審核,再開始遷移。
應用 2:下班後的無人值守工程任務
適合誰:人手少、白天被需求與會議占滿,積壓的修正與重構一直排不上的團隊。
- 法律科技公司 Clio 讓 Opus 5.5 在 6 個程式庫上整夜執行大型工程任務,連續 18 小時以上沒有偏離目標,需要重工的地方很少。
- Chicago Trading Company 的工程師回報,一個他還沒空診斷的服務層錯誤,Opus 5.5 在夜間自行調查、設計並實作修正,早上已通過測試。
- Stripe 的工程師在一次多日的 Rebase 中,由一個 Opus 5.5 工作階段指揮十多個工作階段處理 40 個堆疊的 Pull Request,隔天下午全部通過 CI。
導入重點:「整夜跑」的前提是有明確的完成條件、只能動測試環境、隔天由人驗收後才合併。權限設計可參考〈AI 代理權限邊界與沙箱設計〉。
應用 3:需要逐項查核來源的研究報告
適合誰:業務、行銷、投資與策略部門,需要產業研究、競品分析、客戶背景調查的團隊。
- 官方內部測試讓模型只從一份難以找到財報的網頁副本蒐集資料,撰寫公司季度績效報告,自動評分器逐一比對數字與引言,任何一個捏造的數字都算不及格。Opus 5.5 的 18 份報告有 16 份通過,Fable 5.1 與 Opus 5 一次都沒通過。
- 研究平台 Hebbia 回報,Opus 5.5 在檢索評估中達到該公司歷來最佳的引用召回率(Citation Recall)。
導入重點:這是錯誤率降低,不是零錯誤。對外發布或提供給客戶的報告,仍要保留「每個數字附來源連結」的格式要求,並安排人工抽查。
應用 4:財務模型與決策簡報
適合誰:財務、經營分析、投資評估,以及需要定期產出主管簡報的團隊。
- 官方測試讓 Opus 5.5 與 Opus 5 分析兩家虛構 HR 軟體公司的合併案:先在 Excel 建財務模型,再轉成主管簡報判斷價格是否合理。兩者結論相同,但 Opus 5.5 的模型更完整、簡報更易讀,耗時 63 分鐘對 93 分鐘,成本低 50%;Opus 5 的版本有小錯誤。
- 投資公司 Walleye Capital 回報,Opus 5.5 在較高設定下發現了該公司評估指示中的一個「分鐘索引差一」錯誤並主動修正,這是他們測過的模型中第一次出現。
導入重點:財務工作要把「假設」與「計算」分開輸出。要求模型列出所有假設與資料來源,由財務人員確認假設,再讓模型跑情境分析。
應用 5:程式碼審查與資料分析
適合誰:有程式碼審查流程的開發團隊,以及常被「看起來合理但資料不支持」的結論困擾的資料團隊。
- Deloitte Consulting 回報,Opus 5.5 在最低思考強度下,就抓到程式碼審查中 72% 的已知錯誤;Opus 5 在高強度下是 56%,而且 Opus 5.5 的誤報更少。
- 資料分析平台 Hex 的測試題是判斷「包裹真的延遲,還是只是追蹤系統慢」。Opus 5 查了送達確認就判定追蹤正常;Opus 5.5 則發現包裹確實延遲,而且追蹤系統也壞了。
導入重點:程式碼審查可以先從「只留言、不自動修改」開始。資料分析則要求模型寫出驗證步驟,讓分析師能重跑同一段查詢。
應用 6:在 Slack、Teams 裡工作的內部 AI 助理
適合誰:想讓 AI 處理內部文件問答、例行查詢與跨系統小任務的企業。
- AI 員工服務 Viktor 在 Slack 與 Microsoft Teams 中運作,回報同樣的思考強度下,Opus 5.5 每個任務需要的步驟與工具呼叫更少,成本接近一半,最難任務的正確數量是 Opus 5 的兩倍。
- 企業內容平台 Box 回報,Opus 5.5 使用的 Tokens 是 Opus 5 的三分之一,回答的冗詞減少 40%,準確度沒有下降。
導入重點:內部助理每天被呼叫的次數多,單次成本決定能不能擴大。上線前先設定每人每日用量上限與成本告警,並保留「答不了轉真人」的路徑。
三、使用限制:這三件事要先知道
- 資安與生技請求會被改由其他模型處理。官方表示一般開發流程中修正程式錯誤不受影響,但大多數資安任務會改由 Claude Opus 4.8 處理;生技相關工作受 Fable 5.1 同級防護限制,需申請 Life Sciences Verification Program。做資安或生技的團隊要在日誌中記錄實際回應的模型。
- 思考模式無法關閉。依官方說明,Opus 5.5 不再提供關閉 Thinking 的選項;原本靠關閉思考壓低延遲的串接要重新測試。2026 年 8 月 31 日以後建立的 API 帳號,也適用「Preserved Thinking」防蒸餾機制,會限制修改先前上下文的作法。
- 評估結果不等於正式環境表現。官方坦承 Opus 5.5 經常察覺自己正在被評估,這讓評估結果更難代表真實行為。企業應以自己的樣本與正式環境日誌為準,而不是只看公告數字。
另外一個對台灣企業有利的消息:官方表示 Opus 5.5 與先前的 Opus 模型一樣,可選擇零資料保留(Zero Data Retention),對處理客戶資料或合約內容的團隊是重要的合規選項。
四、挑選第一個 Opus 5.5 應用的四個步驟
以下流程適合還沒有正式上線 AI 代理、想先做一個有數據的試點的團隊。
步驟 1:選定任務,列出候選工作
從上面 6 類情境中,挑出公司裡頻率高、有明確驗收標準、出錯可以回滾的 3 到 5 項工作。例如每週報表彙整、舊程式維護、內部規章問答。先排除會寫入正式資料庫、對外發信或觸發付款的流程。
步驟 2:設定驗收標準
每項工作寫下「什麼叫做完成」與「什麼叫做錯」。研究報告可以是「每個數字都有來源」;程式修正可以是「通過既有測試且不改變對外行為」。沒有驗收標準的工作,不適合交給長時間自主執行的代理。
步驟 3:小規模試跑,量測四個指標
用 30 到 50 個真實樣本試跑,記錄品質、成本、耗時與失敗率。官方與測試者提到,Opus 5.5 在低或中等思考強度下常常已經足夠,例如 Factory 表示它是第一個他們會預設用中等強度的模型;建議從中等強度開始,再依結果調整。評估方法可參考〈AI 導入 POC 的 30/60/90 天評估〉。
步驟 4:上線觀測,保留人工核准
指標達標後才擴大使用範圍。上線後持續記錄實際回應模型、每任務成本與人工修正次數;寫入、送出與付款類動作維持人工核准,具體作法可參考〈企業 AI Agent 執行契約〉。
五、結語:先找對工作,再談換模型
Opus 5.5 的價值不在「更聰明的聊天」,而在讓原本需要一個團隊長時間投入的工作,變成可以排程、可以驗收的例行作業。但能力越強、自主時間越長,驗收標準與權限邊界就越重要。
建議的順序是:先從 6 類情境中找出一個有明確驗收標準的工作,用真實樣本量測,再決定要不要擴大。如果你想評估公司哪些流程適合交給 AI 代理,歡迎參考優創智能的 AI 導入服務,或直接 與我們聯絡 討論你的工作流。
參考來源
- Anthropic,〈Claude Opus 5.5〉,2026-09-22:https://www.anthropic.com/claude-opus-5-5
- Anthropic,〈Claude Opus 5.5 System Card〉:https://anthropic.com/claude-opus-5-5-system-card
相關推薦與延伸閱讀
- Claude Opus 5.5 上線:成本降 40%、長任務更穩,企業 AI 導入該怎麼評估與切換:Anthropic 於 2026 年 9 月 22 日發布 Claude Opus 5.5,官方表示預設設定下執行成本比 Opus 5 低約 40%,Token
- AI Agent 的權限邊界怎麼設:企業導入前必須畫好的三條線:企業導入 AI Agent 前,權限邊界比模型選型更該先決定。本文用 2026 年 OpenAI–Hugging Face 事件與 Google Gemini
- AI Agent 進入 Production 前,FDE 要先建好控制面:企業 AI Agent 的關鍵不是 demo,而是把權限、成本、觀測、評估與人工升級,做成可營運的控制面。本文從三個近期訊號說明權限、成本與安全為何要一起設計,
- Claude Design 正式推出:用對話創作設計稿,台灣企業實用指南:Anthropic 推出 Claude Design,讓非設計師靠對話產出原型、簡報與行銷素材。本文整理功能、適用對象與台灣企業落地建議,解析品牌設計系統繼承、