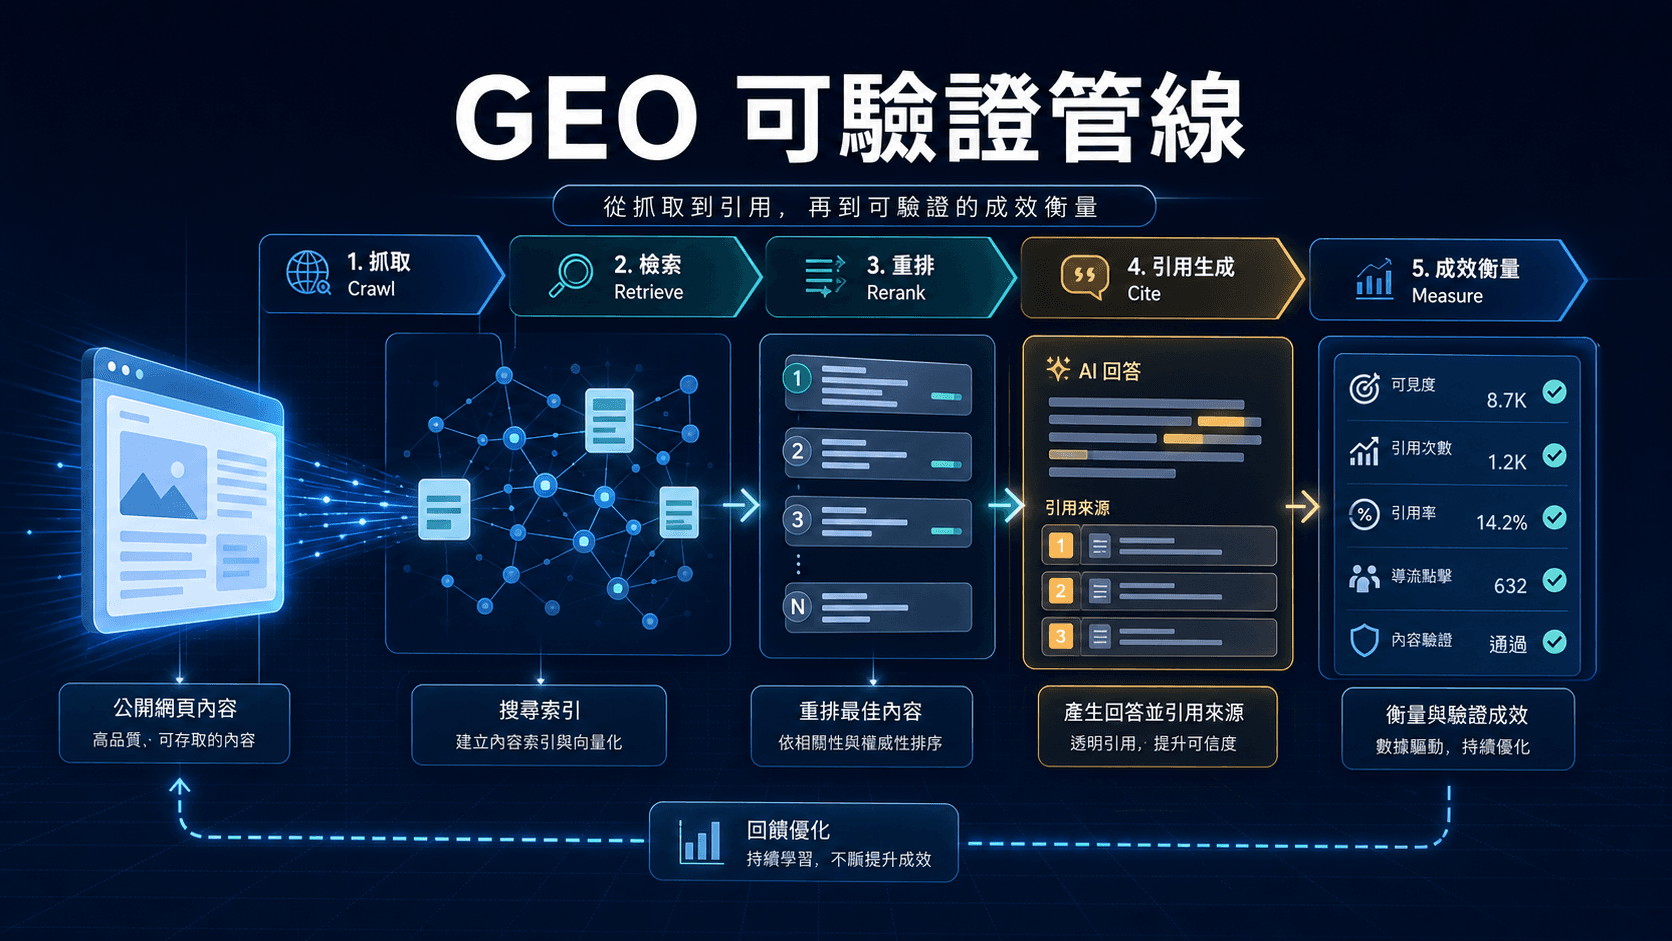
GEO 量測是分別檢查網站可讀性、回答中的品牌提及、網址引用與引用正確性的過程。建立固定題庫並保存原始證據,才能比較變化;llms.txt 存在或網站回傳成功,都不能代替實際引用觀測。
Google 的現行指南表示,其搜尋不使用 llms.txt 作為特殊檔案,也不要求為 AI 刻意切碎內容。Cloudflare 的文章則討論 agent 可讀取、發現、呼叫與支付的網路設計;這與搜尋引用成效是不同的驗收面向。
GEO 綜述將生成引擎描述為部分可觀測的多階段流程。網站方通常無法直接看到平台內部檢索與重排決策;以下四個檢查面向是 YOTRON 的實務方法,不是所有平台共用的排名公式。本文來源已於 2026 年 9 月 9 日重新查閱,連結見文末。
四個可以實際檢查的面向
1. 發現與抓取:先確認 agent 進得來
建立一張重要 URL 清單,至少包含首頁、服務頁、三篇核心文章與 sitemap。每天或每次發布後檢查:
robots.txt沒有誤擋搜尋與合規的 AI crawler。- 公開頁面及必要資源回傳預期狀態與正確內容,沒有挑戰頁或錯誤頁偽裝成成功。
- 主要內容在初始 HTML 可讀,不依賴登入或只有瀏覽器執行後才出現。
- canonical、sitemap 與內部連結指向同一個正式 URL。
這些檢查能發現網站端阻礙,但不能證明特定引擎已經讀取。平台也可能使用既有索引、快取或其他來源;一般瀏覽請求與 crawler 實際存取應分開驗證。
2. 理解與檢索:讓答案引擎拿到可用片段
依讀者的問題清楚組織答案、條件、步驟與來源,讓必要上下文容易找到。標題與內部連結應幫助閱讀,不必為 AI 刻意拆碎文章或套固定字數。這是可讀性建議,不保證平台選取某個片段。
llms.txt 可以提供一份人工整理的文件地圖,尤其適合文件型網站與 agent 取用;但它不是 robots.txt 的權限控制,也不是 Google AI 搜尋的保證排名訊號。做完後要測試的是「agent 依地圖能否在有限請求內找到正確頁面」,而不是只檢查檔案存在。
3. 引用與保真:讓來源被選中且不被誤解
在文章中把事實、分析與建議分開。外部事實附上原始來源、發布日期與連結;自有數據標明樣本、期間與計算方式;推論則直接寫「本文分析」。這讓人工審核有可追溯依據;是否減少引擎誤讀,仍需用實際回答驗證。
結構化資料要與頁面可見內容一致。Article、BreadcrumbList、Organization 等 Schema 是語意提示,不應填入頁面沒有說過的評價、價格或日期。每次發布後用 JSON-LD parser 與頁面文字比對,避免 schema 與正文漂移。
4. 可操作性與安全:agent 能做事,也不能越權
若網站提供預約、報價或查詢功能,公開文件應清楚寫出輸入、輸出、錯誤格式與權限邊界。把讀取型 endpoint 與寫入型操作分開,寫入前確認授權,依操作設計避免重複執行的機制,並記錄必要的操作結果。Cloudflare 的 agentic web 方向提醒我們:可呼叫性必須和治理、驗證一起設計,不能只追求「讓 bot 進來」。
五步建立可重跑的檢查
步驟 1:取得 HTTP 與內容證據
對固定 URL 清單保存 GET 狀態、最終 URL、內容類型及回應內容。HEAD 可做初篩,但不能證明正文正確。檢查 robots、索引指令、canonical、sitemap 與挑戰頁,區分網站回應與實際引擎抓取紀錄。
步驟 2:比對頁面與結構化資料
檢查標題、正文、作者、日期、連結及 JSON-LD,確認資料與可見內容一致。初始 HTML 可讀有助於減少部分工具的執行依賴,但不代表所有引擎都不能處理 JavaScript。
步驟 3:固定問題及觀測條件
選定與業務相關的題庫,分開品牌題與未指定品牌的需求題。固定引擎、模式、搜尋設定、地區及登入條件;每題使用獨立對話,保存原始問題、時間、頁面版本與回答。
題數與重複次數依目的安排,不能把少量樣本當作整體市場。額度不足、登入失敗或回答未完成時,記錄原因,不改模式湊成功數。
步驟 4:分開記錄提及、引用與正確性
展開完整來源清單,分別記錄品牌提及、本站網址與目標頁引用,再逐項核對來源是否支持回答。若來源未完整取得,引用狀態保留未知,不能當作沒有引用。
| 指標 | 分子/分母與界線 |
|---|---|
| 品牌提及率 | 提及品牌的完整回答數/可判定提及的回答數 |
| 本站引用率 | 含本站來源的回答數/來源完整且可判定的回答數 |
| 目標頁引用率 | 含指定頁面的回答數/來源完整且可判定的回答數 |
| 引用正確比例 | 經人工核對且支持對應說法的引用數/已完成核對的引用數 |
| 觀測完成率 | 完成觀測數/原定觀測數;另列失敗及未知原因 |
回答層級與引用層級的分母不同,不能混算。沒有有效分母時標示「無法計算」,不要填成 0%。每個比例都附樣本數;不同模式或題組分開呈現。
步驟 5:保存並比較證據
保存固定題庫、原始回答、完整來源、人工判讀與頁面版本,再按相同條件重跑。若頁面尚未重新索引、平台模式改變或觀測覆蓋不同,明列限制。
發布前後差異只能先視為觀察結果,不能單憑它宣稱修改造成引用成長。追蹤訪問與詢問等業務結果時,也須與回答引用分開呈現。
優先修正什麼?
先處理重要公開頁面的存取與錯誤資訊,再改善閱讀、來源與資料一致性,接著建立可重跑的引用觀測。llms.txt 若有實際使用者或工具需求,可作為維護中的導覽索引;不要用檔案數量代替內容品質。
來源與判讀界線
- Google Search Central:針對 Google 搜尋中的生成式 AI 功能進行優化的指南,本次回讀標示更新日為 2026-07-15。這是 Google 對 AI 搜尋技術要求的官方說明。
- Cloudflare Blog:Building an open Agentic Internet,2026-08-06。這是 Cloudflare 對 agent 可發現、可讀取、可呼叫與治理的工程觀察。
- arXiv:Optimizing Visibility in Generative Engines: A Critical Survey of Generative Engine Optimization (2023–2026),arXiv 標示提交日為 2026-07-15。這是研究者對 GEO 多階段流程與評估問題的綜述。
- llms.txt v2 規格,2026-09-09 回讀。這是提案本身對
llms.txt用途與robots.txt差異的說明,不代表任何平台已承諾採用。
上述來源分別提供平台說明、工程觀點、研究綜述與文件提案,證據性質不同。本文指標的分母與檢查方法是 YOTRON 的操作定義,應在每次觀測前固定,不能當成平台內部評分。
相關推薦與延伸閱讀
- llms.txt 實作指南:用 Markdown 內容協商提升 GEO 可讀性:從 llms.txt v2 出發,示範如何建立 AI 可讀文件索引、用 rel=alternate 提供 Markdown 版本,並以 HTTP smoke t
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試
- GEO 引用驗證:用固定查詢找出 AI 搜尋的真實缺口:AI 搜尋的曝光不是單一排名。本文把 GEO 轉成固定查詢、引用證據與正確性回歸測試,分開觀測條件、有效分母與失敗原因,避免從單次答案推定成效。內容包含如何定義
- Vercel 推出 Is Agentic:一鍵評分你的網站對 AI Agent 的可讀性與可用性:Vercel 的 Is Agentic 掃描網站,替 AI agent 可發現、可存取、可理解、可操作打分 0–100。解析評分邏輯與 GEO 落地用法,說明它
- llms.txt v2 實作:用 Markdown 內容協商提升 AI agent 可引用性:llms.txt v2 把 AI agent 導覽從索引延伸到 Markdown 內容協商。本文提供不依賴排名承諾的實作、驗證與治理流程:先分清三個表面,再完成