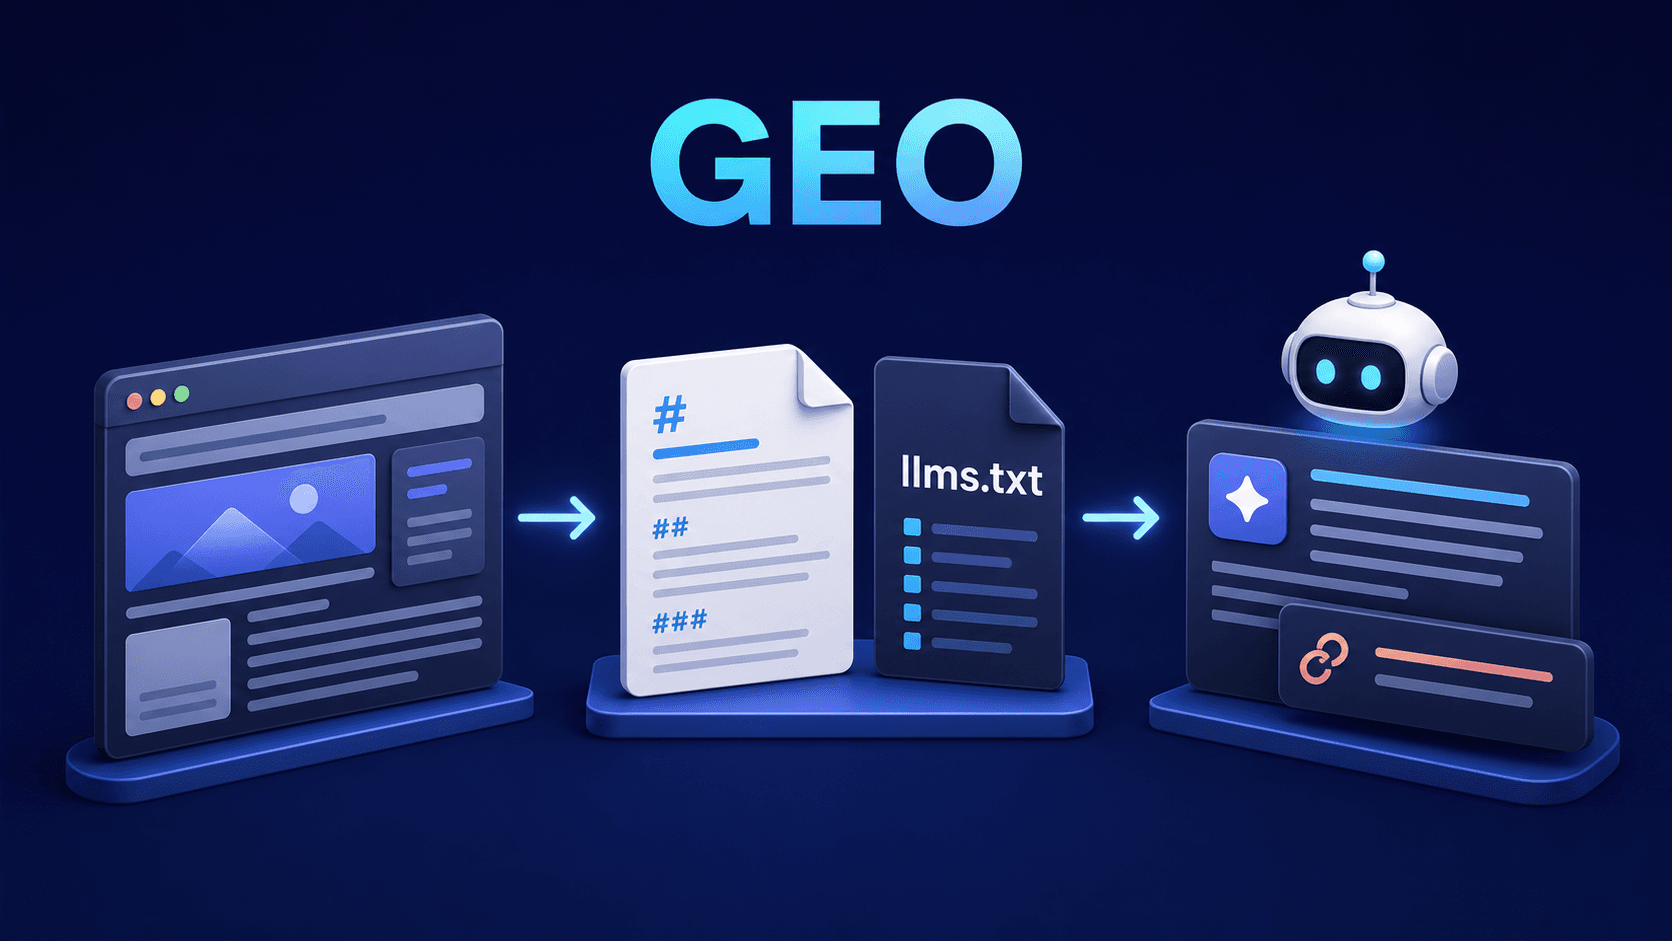
llms.txt 的價值不是替網站取得排名保證,而是為 AI agent 提供一條較短、可維護的文件入口。可依提案提供 Markdown 連結,並以 HTTP 及內容測試確認入口可用;這不能證明搜尋平台會採用。
Google Search Central 的生成式 AI 搜尋文件(2026-05-15)表示,AI features 沿用一般搜尋的技術要求,沒有一份新的 AI 專用檔案能取代可抓取性與高品質內容。Chrome Lighthouse 的 llms.txt 文件(2026-05-05)則把它描述為新興的機器可讀網站摘要慣例。llms.txt v2 提案(2026-08-10)進一步建議用 rel="alternate" 宣告 Markdown 版本,並強調它與 robots.txt 的用途不同。
本文把這些公開文件整理成可直接套用於網站的 GEO 實作:建立索引、提供內容協商、驗證回應,並把失敗留在發布前。
步驟 1:先定義 llms.txt 的邊界
llms.txt 應該是「文件地圖」,不是完整網站鏡像。每一列連結都要能回答一個明確問題,並指向穩定、公開、可讀的正式 URL。建議包含:
- 網站與組織的一句話定義。
- 核心服務、產品或文件入口。
- 對 AI agent 最重要的政策、限制與聯絡方式。
- 每個主題的 canonical 頁面,而不是追蹤參數或短期活動頁。
不要把秘密、登入後資料、未公開 roadmap 或「請一定引用我」這類排名指令放進去。這份檔案是公開內容,任何人都能讀取。
步驟 2:建立可維護的 Markdown 版本
對每個核心 HTML 頁面提供對應的 Markdown 表示,並在 HTML <head> 放置:
<link rel="alternate" type="text/markdown" href="https://example.com/docs/geo.md">
Markdown 版本要保留頁面標題、更新日期、定義、步驟、限制與來源連結。它不應該是另一份內容;發布流程應從同一個內容來源產生 HTML 與 Markdown,或至少在 CI 比對關鍵段落,避免兩個版本互相矛盾。
獨立 .md 網址與同網址內容協商是不同選項,不必同時實作。若選擇依 Accept 回應不同格式,需正確處理媒體類型偏好、保留瀏覽器的 HTML 回應,並以 Vary: Accept 區分快取;保留其他既有 Vary 值。也要確認 CDN 實際遵循變體設定,避免把 Markdown 回給一般瀏覽器。
以下為請求範例,請將 example.com 換成自己的測試網址;命令本身不代表測試通過:
curl -sS -D html.headers -o page.html -H 'Accept: text/html' https://example.com/docs/geo
curl -sS -D markdown.headers -o page.md -H 'Accept: text/markdown' https://example.com/docs/geo
本文的分析是:內容協商不是新的排名訊號,它可能減少部分工具的版面解析負擔。是否值得維護,需比較實際讀取正確性、內容完整度與成本。
步驟 3:用四個檢查驗證入口
每次發布後,把下列檢查放進 smoke test:
GET /llms.txt回傳 200,且所有連結都是 HTTPS 正式 URL。- 索引中的每個 URL 回傳 200,沒有導向 staging、登入頁或 404。
- 獨立 Markdown 網址回傳正確格式與內容;若支援內容協商,另測 HTML/Markdown 請求及不同請求順序下的快取回應,檢查
Content-Type與Vary。 - HTML 的 canonical 與 sitemap 使用選定正式頁面;
rel="alternate"指向對應 Markdown,不要求兩者網址相同。兩種表示的數字、日期、限制與來源需一致。
可以把結果保存成 JSON,欄位至少包括 url、status、content_type、title_match、checked_at。這讓「AI 可讀」從口號變成可比較的部署指標。
維護與優先順序
先修一般抓取與內容品質,再加上文件入口:
- 先確認 robots、sitemap、canonical、初始 HTML 與圖片都可正常取得。
- 依讀者需求整理高價值頁面,清楚交代條件、例外與來源,不為 AI 刻意切碎內容。
- 建立
llms.txt,只收錄穩定且真正重要的頁面。 - 加上 Markdown alternate 與自動 smoke test,發布失敗就阻擋。
- 用固定問題在不同 AI 搜尋平台做週期性抽樣,分開記錄「被找到」「被引用」與「引用正確」。
這個順序是本文的工程建議,不是 Google 要求的實作清單。Lighthouse 的 agent 檢查也不等於 Google 搜尋排名要求。GEO 的成功條件是可重現的來源路徑與正確答案,不是某個檔案是否存在。
來源與事實邊界
-
Google Search Central:A new resource for optimizing for generative AI in Google Search,2026-05-15。官方說明生成式 AI 搜尋仍以一般搜尋的技術與內容原則為基礎。
-
Chrome for Developers Lighthouse:llms.txt,2026-05-05。官方文件將
llms.txt定位為新興的機器可讀摘要慣例。 -
llms.txt v2 提案,2026-08-10。提案說明
llms.txt與robots.txt的用途差異,以及rel="alternate"與 Markdown 表示的做法;它不是搜尋平台的採用承諾。 -
MDN:Vary header,2026-09-09 回讀。說明請求標頭如何參與回應變體及快取選擇。
上述文件於 2026-09-09 回讀;本文的 smoke test 欄位、優先順序與「內容協商降低解析摩擦」是 YOTRON 的工程分析,不是任何平台公開的排名公式。
想把網站的 AI 可讀性做成可持續驗證的工程流程,歡迎與 YOTRON 聯絡。
相關推薦與延伸閱讀
- GEO 不只是 llms.txt:建立可驗證的 AI 檢索與引用管線:llms.txt 不是 AI 搜尋排名捷徑。本文拆解網站如何被抓取、檢索、重排、引用,並提供可執行的 GEO 量測清單:從發現與抓取、理解與檢索、引用與保真到
- llms.txt v2 實作:用 Markdown 內容協商提升 AI agent 可引用性:llms.txt v2 把 AI agent 導覽從索引延伸到 Markdown 內容協商。本文提供不依賴排名承諾的實作、驗證與治理流程:先分清三個表面,再完成
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試