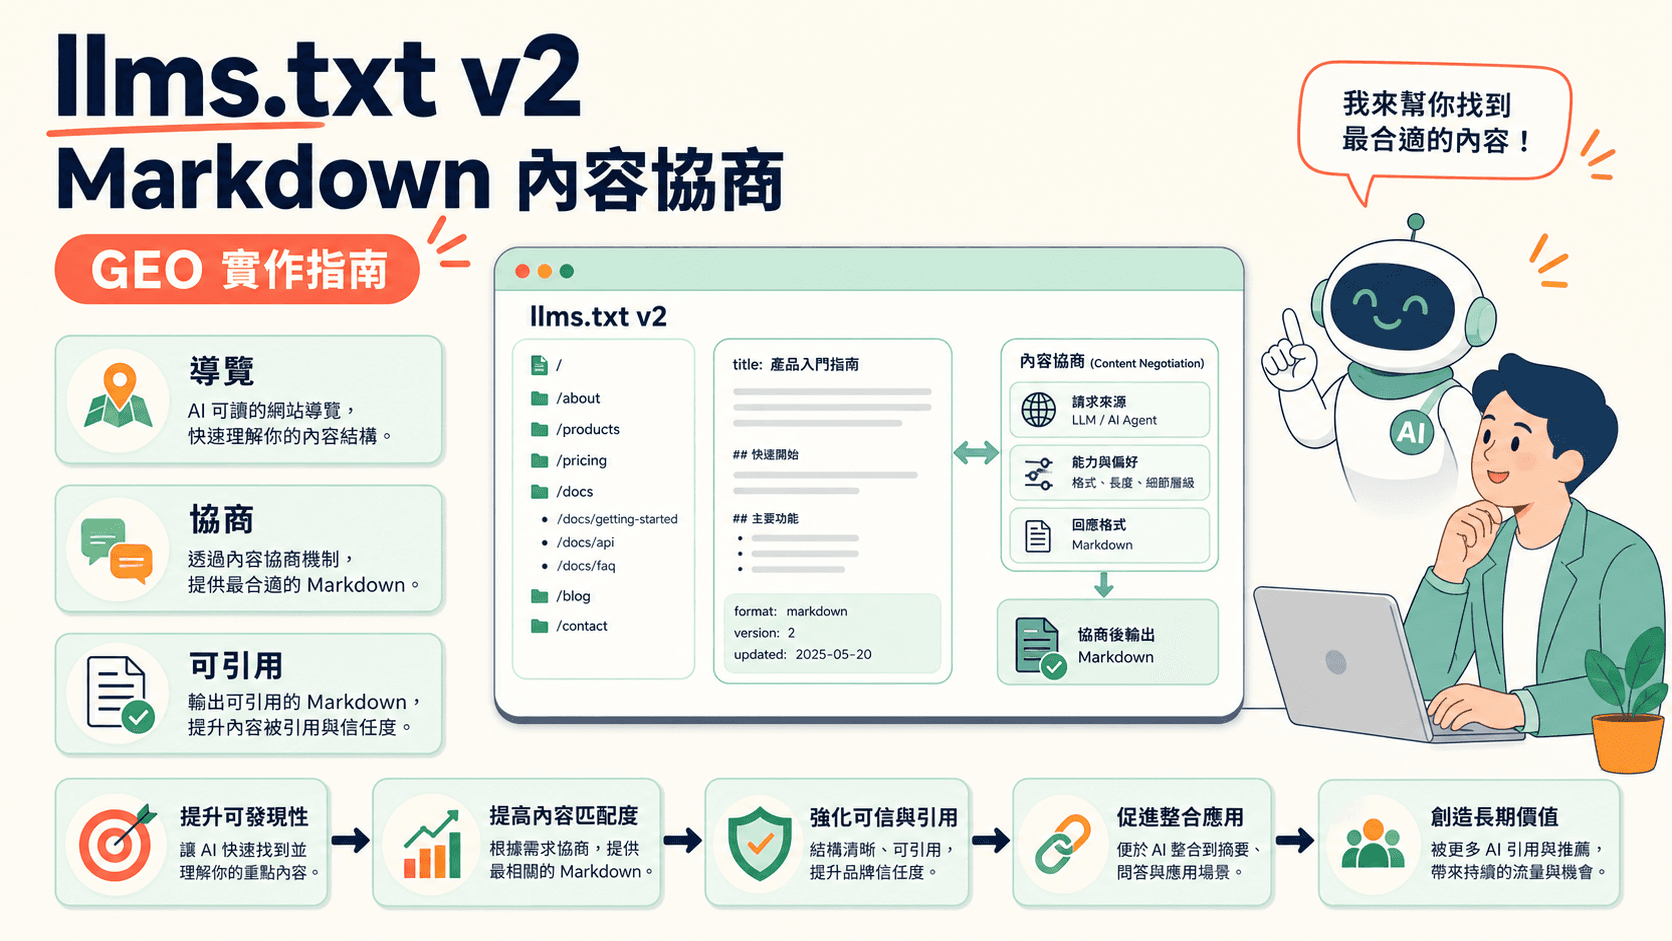
llms.txt v2 的重點不在於再增加一個「排名檔案」,而是讓網站能向 AI agent 宣告:哪些頁面值得先讀,以及同一頁是否提供較低噪音的 Markdown 表示。這是一份選用的可讀性契約,不是 Google AI 搜尋的排名保證。
先分清三個表面
把同一份內容拆成三個可觀測表面,避免把規格提案誤當成平台承諾:
- HTML:供人類閱讀,供搜尋引擎索引,並提供 canonical 連結。
/llms.txt:提供網站身分、重要頁面與閱讀順序的短索引。- Markdown alternate:提供同頁的另一種表示,可以是獨立
.md網址;同網址依Accept協商是另一種設計,不是必要條件。
Google Search Central 的 AI optimization 指南表示,出現在 AI Overviews 或 AI Mode 不需要新增 AI 檔案、特殊 Schema 或 Markdown。相對地,llms.txt v2 規格把它定位成 agent 按需使用的導覽慣例。因此工程團隊應量測「是否被請求、是否減少解析成本、引用是否忠實」,不要宣稱排名提升。
最小實作:索引與內容協商
獨立 Markdown 網址與同網址內容協商的選擇,見 實作指南。以下只示範選擇內容協商時的請求方式,不代表本站已有此端點:
GET /docs/getting-started
Accept: text/markdown
若伺服器選擇 Markdown 回應,使用 Content-Type: text/markdown; charset=utf-8;依 Accept 分流時需設定 Vary: Accept 並驗證 CDN 的快取變體,並保留:標題、版本、程式碼、限制與來源連結。HTML 與 Markdown 應由同一份內容資料生成,避免兩份手工文字漂移。
/llms.txt 只列出已存在且可公開存取的 URL。以下是假設文件站範例,發布前需換成自己的有效網址:
# Example 文件
> AI agent 導覽;完整內容仍以各頁 HTML 為準。

## 核心指南
- [GEO 引用驗證](https://example.com/docs/citation.md)
- [Agent readiness](https://example.com/docs/readiness.md)

## 使用規則
- 請先讀取頁面日期與限制
- 不要把本文索引當成授權或排名訊號
不要把秘密、未公開草稿或需要登入的 URL 放進索引。robots.txt 仍負責爬蟲存取政策;llms.txt 是內容導覽,兩者不能互相取代。
驗證「可引用」而不是檔案存在
建立固定查詢集,將請求觀測與答案判讀分開。以下為假設的格式,並非實測結果;request_surface 無法證明時填 unknown,cited_url 必須放網址:
run_at,engine,query_id,request_surface,page_version,cited_url,faithful,answer_url
2026-08-30T09:00:00+08:00,example-engine,geo-001,unknown,example-version,https://example.com/docs/citation,unknown,https://example.com/example-answer
至少檢查四件事:
request_surface是否真的出現llms.txt或text/markdown請求。cited_url保存實際引用網址,再另判斷是本站、目標頁或其他頁;不能把觀測網址直接改成預期 canonical。faithful是否保留日期、條件與限制。page_version是否能回到測試時的網站版本;若無法證明引擎讀取版本,不把當前雜湊當成其索引版本。
若只看到 HTML 請求,不要把 /llms.txt 的發布當成 agent 採用證據。若引用遺漏限制,先核對原文及來源版本,再判斷是內容表達或引擎回答問題;不能假設重寫就能修復引用。
發布前 QA
curl -i https://example.com/llms.txt
curl -i -H 'Accept: text/markdown' https://example.com/docs/getting-started
curl -i https://example.com/docs/getting-started
索引應能導覽到目標頁;索引本身不需要與文章具有相同標題。HTML 與 Markdown 表示則需核對同一內容的事實、日期及來源,並測試不同請求順序不會造成快取格式混用。再用兩個允許網路搜尋的引擎執行固定查詢,保存引用 URL 與答案版本;單次模型回答不能證明因果。
來源與判讀界線
- llms.txt v2 規格,2026-08-10:說明索引、Markdown 表示與按需使用的設計。
- Google Search Central:針對生成式 AI 功能進行優化,2026-09-09 回讀:未要求 llms.txt、特殊 AI 檔案或專用 Schema。
- Cloudflare:Building an open Agentic Internet,2026-08-06:將 agent web 分成 readable、discoverable、callable 等能力。
上述文件支持規格定位、Google 的限制與 agent 可讀性分層;事件欄位、內容雜湊與回歸查詢是 YOTRON 的工程實作分析,不是平台公布的排名演算法。
結語
把 llms.txt v2 當成可測試的內容介面:HTML 維持公開 canonical,索引只負責導覽,Markdown 可由獨立網址提供,或透過正確實作的內容協商選取。最後用請求紀錄、版本雜湊與引用忠實度驗證它是否真的改善 agent 工作流程。
相關推薦與延伸閱讀
- llms.txt 實作指南:用 Markdown 內容協商提升 GEO 可讀性:從 llms.txt v2 出發,示範如何建立 AI 可讀文件索引、用 rel=alternate 提供 Markdown 版本,並以 HTTP smoke t
- GEO 不只是 llms.txt:建立可驗證的 AI 檢索與引用管線:llms.txt 不是 AI 搜尋排名捷徑。本文拆解網站如何被抓取、檢索、重排、引用,並提供可執行的 GEO 量測清單:從發現與抓取、理解與檢索、引用與保真到
- Vercel 推出 Is Agentic:一鍵評分你的網站對 AI Agent 的可讀性與可用性:Vercel 的 Is Agentic 掃描網站,替 AI agent 可發現、可存取、可理解、可操作打分 0–100。解析評分邏輯與 GEO 落地用法,說明它