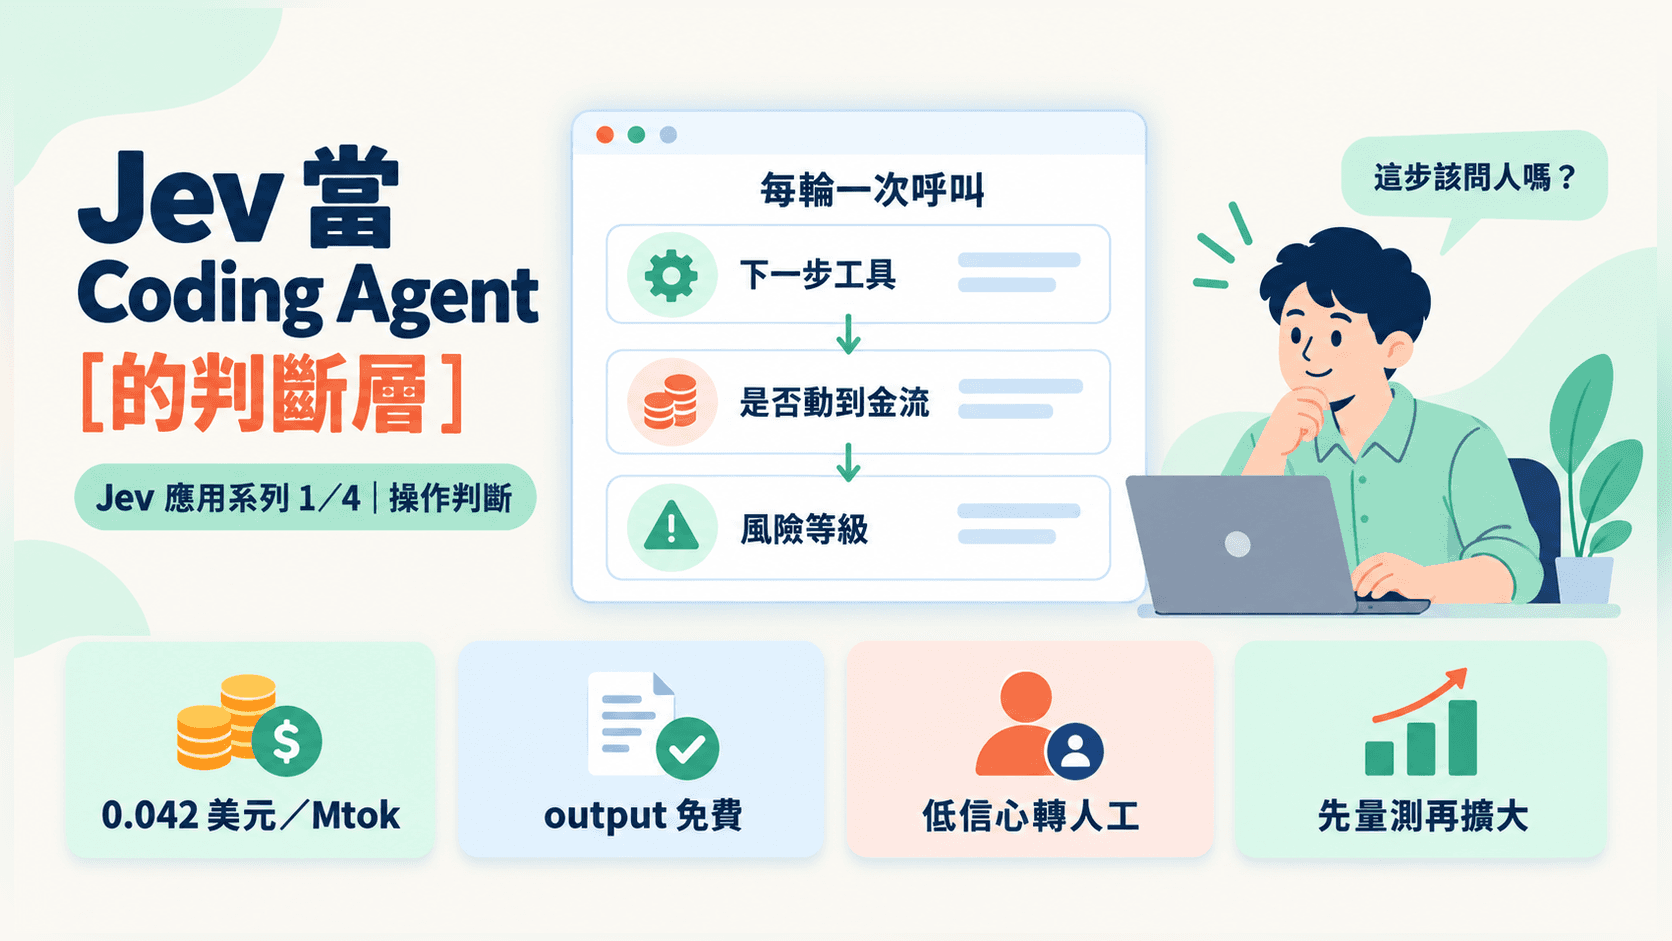
Jev 是 TypeSafe 的 System One model,它的定位不是寫程式,而是做判斷。把 coding agent 裡「該用哪個工具、該不該讀這個檔案、這個修改該不該送人審」這類判斷從生成式模型移到 Jev,是目前最值得量測的一種架構調整:Jev 官方定價為每百萬 input token 0.042 美元、output token 免費,同樣 input 量約為 Opus 級模型的 1/119。結論先說,這個架構有真實的成本與延遲理由,但「Codex 快 10 倍」是社群使用者的體感宣稱,不是官方 benchmark,導入前必須用自己的任務量測。
社群開發者 Sac 在 2026-09-18 的貼文中建議大家親自試 Jev,並列出四個場景:computer use 的操作判斷層、上下文壓縮、模型路由、自動審核。Sac(@Saccc_c)X 貼文,2026-09-18 本文只處理第一個場景,並且把宣稱與可驗證事實分開:官方文件提供的是價格、rate limit、context 上限與已知失效模式;「速度提高 10 倍」與「省下大量 token」則屬於個人使用經驗,本文不當成保證。
Coding agent 真正浪費錢的地方
一個 coding agent 的迴圈裡,並不是每一次模型呼叫都在生成程式碼。大量呼叫其實只是在回答一個很小的問題:
- 這個使用者需求該先讀檔還是先搜尋?
- 這 40 個搜尋結果裡,哪幾個值得完整讀進上下文?
- 這次修改屬於低風險格式調整,還是會動到金流邏輯?
- 現在的資訊夠不夠完成任務,還是該停下來問人?
這些都是判斷,不是生成。但在典型實作裡,它們仍然走同一條路:把整份上下文送進最貴的模型,讓它輸出一句話或一個 JSON,程式再解析。你付的是生成式模型的 input 價格、生成式模型的延遲,換回一個布林值。
Jev 的產品設計正好對上這一段。它接收 state,針對預先定義的 Choice、Score、Noul 問題回傳 typed values 與機率分布,所有問題對同一份 state 平行評估,不逐 token 生成。TypeSafe Docs〈Primitives〉,查閱 2026-09-18
官方可查的成本與限制
導入判斷層前,先把官方數字放在桌上。以下是 TypeSafe Models 頁面對 jev-1.13.0 的說明:
| 項目 | 官方數值 |
|---|---|
| 價格 | 每 Btok(十億 token)42 美元,即每 Mtok(百萬 token)0.042 美元 |
| 計費方式 | 只計 input token,output token 免費 |
| Rate limit | 每秒 250,000 tokens/每分鐘 1,200 requests |
| Context | 每次請求 64k tokens;state 加上最長的單一問題不超過 32k |
| 輸入格式 | 純文字(字串、JSON 物件或文字陣列),不支援圖片、音訊、影片 |
TypeSafe Docs〈Models〉,查閱 2026-09-18
同一頁也有兩個台灣團隊必須先看的限制。第一,rate limit 正在動態調整,官方明說在需求量很大的期間可能未經通知變動,穩定上限要走 custom 或 enterprise 方案。第二,Jev 的主要訓練語言是英文,CJK 文字準確度較低,官方建議在自己的非英文內容上先測試,並在路由時特別留意 confidence。這一點對繁體中文流程的影響比價格大得多。
把判斷層寫成一次 fan-out 呼叫
官方 Speculative fan-out pattern 的重點是:一次請求可以塞進所有你可能需要的問題,額外問題通常不增加延遲,程式再決定哪些答案相關。TypeSafe Docs〈Speculative fan-out〉,查閱 2026-09-18
對 coding agent 來說,這意味著每一輪迴圈只要一次 Jev 呼叫,就能拿到整棵決策樹需要的訊號:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

# state 只放這一輪判斷需要的東西:使用者需求、候選工具、工作區摘要。
# 不要把整份 repo 或完整對話塞進來 — 官方 jaggedness 文件把
# 「large state full of irrelevant detail」列為明確的失效模式。
turn_state = {
    "user_request": request_text,
    "available_tools": tool_names,
    "recent_actions": last_actions,
    "pending_diff_summary": diff_summary,
}

answers = client.system_one(
    state=turn_state,
    questions={
        "next_tool": Choice(
            instructions="Which tool should run next to make progress on user_request?",
            criteria={
                "search": "The agent still needs to locate relevant files",
                "read": "The target file is known and must be read",
                "edit": "The change is understood and can be written now",
                "run_tests": "A change exists and needs verification",
                "ask_human": "Requirements are unclear or the action is irreversible",
            },
        ),
        "touches_money_path": Noul(
            instructions="The pending diff changes payment, billing, or refund logic.",
        ),
        "risk": Score(
            instructions="How risky is applying the pending diff without human review?",
            criteria=[
                "Formatting or comments only",
                "Local logic change with test coverage",
                "Cross-module or data-affecting change",
            ],
        ),
    },
).answers
三個問題都對同一份 state 評估,一次呼叫拿回。接下來的控制流程留在程式碼裡:
tool = answers["next_tool"]
risk = answers["risk"]

# 低於門檻一律交人,不要讓 agent 自行降級處理。
if tool.confidence < 0.6:
    return ask_human(reason="low confidence on next action")

if answers["touches_money_path"].noul > 0.5 or risk.score > 1.5:
    return open_review_request(diff_summary)   # 人工審核,不自動 apply

return dispatch(tool.choice)
官方 Confidence-gated routing pattern 的原則是「答案告訴你是什麼,confidence 告訴你能不能動手」,並建議不同風險等級套不同門檻。TypeSafe Docs〈Confidence-gated routing〉,查閱 2026-09-18 把不可逆動作的門檻拉高、低於地板值直接轉人,是這個架構能不能安全上線的關鍵,而不是省下多少 token。
這個架構會踩到的四個坑
TypeSafe 自己維護一份 jev-1.13 jaggedness 清單,最後檢閱日期 2026-09-17。以下四項直接影響 coding agent 判斷層的設計。TypeSafe Docs〈Jev 1.13 jaggedness〉,查閱 2026-09-18
- 字面理解:Jev 回答你寫下的問題,不是你想問的問題。否定句、範圍詞都照字面讀。
instructions要寫出精確條件,邊界案例放進 criteria。 - 不會算數:計數與數值比較不可靠,錯誤隨數量增長。改動行數、檔案數、日期先後一律在程式裡算完再餵進去。
- 大 state 會降準確度:無關內容是干擾項。官方建議先在程式裡檢索與過濾,只送問題需要的欄位。這與「把整個 repo 丟給模型」的直覺相反。
- state 不被視為敵意內容:注入指令、誘導性措辭可能移動答案。對 coding agent 特別危險 — 被讀進來的檔案、issue 內文、依賴套件的 README 都是 state。判斷層不能當成安全邊界。
還有一項結構性提醒:同一個問題用 Noul 問與用 yes/no Choice 問,數值不可互換,官方明確說不要把在 Noul 上調好的門檻搬到 Choice 上。這代表你的門檻常數必須集中在一個檔案裡,並且綁定問題型別與模型版本。
導入前的四步量測
步驟 1:先統計 agent 有多少呼叫只是在判斷
翻你現有的 agent 記錄,把每次模型呼叫標成「生成」或「判斷」。統計判斷類呼叫的次數、平均 input token 與累計成本。沒有這個基線,後面所有節省幅度都是推測。若還沒有可用的成本記錄,可先參考台灣企業導入 AI Agent:真正要算的不是 token,而是工作流成本的量測方式。
步驟 2:在你自己的中文語料上測準確率
抽 100 個真實的判斷情境,由熟悉流程的工程師標記正確答案。分別用現行做法與 Jev 跑一次,比較準確率、未知率與 confidence 校準。繁體中文要單獨測:官方已說明 CJK 準確度較低,英文範例的門檻不能直接套用。若中文結果不穩定,先測「state 用英文摘要、原文另存」的版本再比較。
步驟 3:量全程延遲,不只量模型延遲
把 Jev 呼叫接成影子模式:只記錄、不改變 agent 行為。量從發出請求到程式做完路由決策的 p95,包含跨區網路與你自己的檢索時間。官方 rate limit 可能變動,429 的退避與重試也要一起計入延遲預算。
步驟 4:從可回滾的低風險判斷開始
第一個上線的判斷不要選「要不要 apply 這個 diff」,選「要不要把這個搜尋結果讀進上下文」這種錯了也能補救的決策。把門檻常數、問題文字與模型版本號放在單一檔案接受 code review,設好逾時轉人工與回滾開關,再逐步擴大。需要協助界定第一個試行範圍時,可聯絡優創智能。
結論:判斷層值得測,但不是免費的加速器
把 coding agent 的判斷外包給 Jev,理由是清楚的:判斷不需要生成,而生成式模型的 input 價格與延遲都在為你不需要的能力付費。官方的 0.042 美元/Mtok、output 免費、平行評估多個問題,讓這個分工在架構上說得通。
但它不是把 agent 接上去就變快的開關。你要付的代價是:一份維護中的問題與門檻常數檔、一次真實語料的校準量測、繁體中文準確度的額外驗證,以及一個「判斷層不等於安全邊界」的清楚認知。先量測第一步,再談第 10 倍。
來源與查閱日期
- Sac(@Saccc_c),Jev 四大應用場景貼文,2026-09-18。X 貼文
- TypeSafe Docs,〈Models〉(價格、rate limit、context、語言支援),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Speculative fan-out〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Confidence-gated routing〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Quick start〉(API 請求與回應結構),查閱 2026-09-18。官方文件
相關推薦與延伸閱讀
- 用 Jev 做上下文壓縮:把 Agent 的「該留哪一段」從生成改成打分:上下文壓縮不是摘要問題,是取捨問題。本文說明如何用 Jev 對每個段落打分再由程式決定去留、為什麼 Jev 的 64k context 反而逼出更好的架構,以及
- Jev 是什麼?TypeSafe System One 模型如何讓 AI 成為企業決策函式:Jev 是 TypeSafe 的第一個 System One model。本文拆解 typed questions、機率與 confidence 的差異,並說明
- 5 個行政自動化場景:會議、郵件、排程與報表驗收:從會議摘要、郵件草稿、社群排程到費用及定期報表,整理行政自動化的輸入、人工覆核與驗收方式,不把工具設定完成當成效益保證。