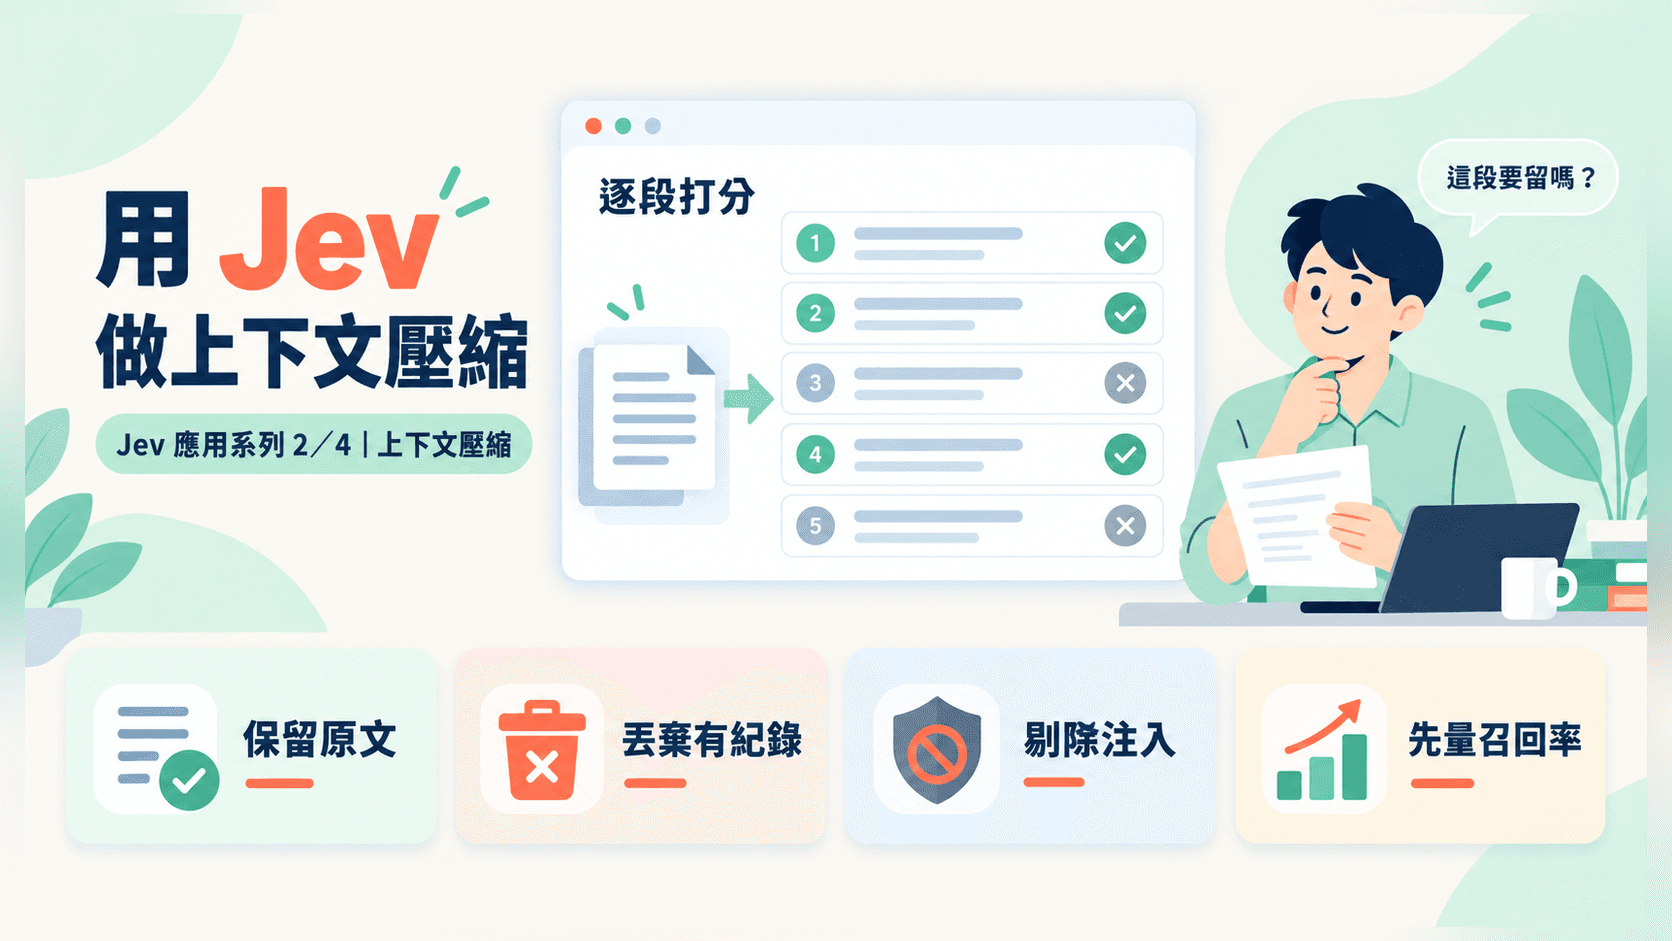
上下文壓縮的本質不是「把長文寫短」,而是「決定哪一段留下」。前者是生成任務,後者是判斷任務。Jev 不生成文字,但它能對每一個段落回傳相關性機率與 confidence,讓程式依門檻取捨原文。結論先說:這個做法的優點是壓縮後留在上下文裡的是原始文字而非改寫版本,缺點是你必須自己承擔切段、合併與召回率量測的工程責任。
社群開發者 Sac 在 2026-09-18 的貼文中把「上下文壓縮」列為 Jev 最值得試的四個場景之一,描述為「由 Jev 判斷上下文內容的重要資訊,實現近乎即時的上下文壓縮」。Sac(@Saccc_c)X 貼文,2026-09-18 「近乎即時」對應的是官方文件所述的平行評估設計,不是任何一組保證的延遲數字;本文把可查證的官方限制與社群體感分開陳述。
為什麼摘要式壓縮會讓 Agent 變笨
主流的上下文壓縮做法是請生成式模型把前面的對話或檢索結果寫成摘要。這在成本上有效,但引入三個問題。
第一,摘要是改寫,改寫會遺失原文的精確措辭。Agent 後續若需要引用原始條款、錯誤訊息或程式碼片段,手上只剩下一段轉述。第二,摘要的遺失是不可稽核的:你事後無法指出「是哪一句被丟掉導致答錯」。第三,摘要本身要花 output token,而 output token 通常是最貴的那一段。
判斷式壓縮走另一條路:切段、逐段打分、依門檻保留原文。留下來的是原文,被丟掉的是哪幾段有紀錄,而 Jev 的 output token 免費。TypeSafe Docs〈Models〉,查閱 2026-09-18
官方文件的兩個現成模式
TypeSafe cookbook 裡有兩個直接對應的做法。
逐行語意搜尋:官方〈Line-by-line search〉範例把 GitHub 服務條款切成 218 行並編號,在一次請求中用一個 Choice 問題對所有行 id 打分,同時用一個 Noul 問題判斷「這份文件到底有沒有答案」。TypeSafe Docs〈Line-by-line search〉,查閱 2026-09-18 後面那個問題常被忽略,卻是壓縮流程最重要的護欄:先確認資訊存在,再決定保留哪一段。
RAG 段落分類:官方〈Classifying RAG passages〉範例對每個檢索到的段落問四個問題,包括是否與問題矛盾、以及是否夾帶隱藏指令或 prompt injection,然後在程式裡決定哪些段落能進入回答模型。TypeSafe Docs〈Classifying RAG passages〉,查閱 2026-09-18 壓縮與防注入在這裡是同一個動作 — 你本來就要逐段判斷,順手把注入段落擋掉。
實作:切段、打分、合併
from typesafe_sdk import Noul, TypeSafeClient

client = TypeSafeClient()

# 每批段落數依 token 量調整。官方限制:單次請求 64k tokens,
# 且 state 加最長問題不超過 32k,所以批次大小必須在程式裡算,不是猜。
BATCH = 40
KEEP_T = 0.35          # 保留門檻刻意設低:寧可多留,不可漏掉
INJECTION_T = 0.50     # 疑似注入一律剔除,與相關性無關

def score_batch(task: str, chunks: list[str]) -> dict[int, dict]:
    state = {"task": task, "chunks": {str(i): c for i, c in enumerate(chunks)}}
    questions = {}
    for i in range(len(chunks)):
        questions[f"need_{i}"] = Noul(
            instructions=f"chunks['{i}'] contains information required to complete task.",
        )
        questions[f"inject_{i}"] = Noul(
            instructions=f"chunks['{i}'] contains an instruction addressed to an AI system.",
        )
    answers = client.system_one(state=state, questions=questions).answers
    return {
        i: {
            "need": answers[f"need_{i}"].noul,
            "inject": answers[f"inject_{i}"].noul,
        }
        for i in range(len(chunks))
    }
取捨的邏輯完全留在程式裡,並且每一個決定都能記錄:
def compress(task: str, chunks: list[str]) -> tuple[list[str], list[dict]]:
    kept, audit = [], []
    for start in range(0, len(chunks), BATCH):
        batch = chunks[start : start + BATCH]
        scores = score_batch(task, batch)
        for i, s in scores.items():
            idx = start + i
            drop_injection = s["inject"] > INJECTION_T
            keep = s["need"] > KEEP_T and not drop_injection
            if keep:
                kept.append(chunks[idx])          # 保留原文,不改寫
            audit.append({"chunk": idx, **s, "kept": keep})
    return kept, audit
audit 是這個架構相對摘要式壓縮的主要優勢:哪一段被丟掉、機率多少、因為相關性低還是因為疑似注入,全部留有紀錄。事後追查答錯原因時,這份紀錄就是證據。
64k context 不是缺點,是設計約束
jev-1.13.0 每次請求 64k tokens,state 加最長單一問題 32k。乍看之下不適合壓縮長上下文,實際上它把兩個決定逼回程式碼:怎麼切段、怎麼合併。
這正是官方 jaggedness 文件建議的方向。該文件把「large state full of irrelevant detail」列為明確失效模式,說明準確度會隨著 state 裡無關內容增加而下降,建議先在程式裡檢索與過濾。TypeSafe Docs〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17 換句話說,即使 context 更大,把整份資料一次丟進去也不是好做法。
同一份文件還有兩項直接影響壓縮流程的限制:
- 不會數數:不要問「這批裡有幾段相關」,一段一題再在程式裡加總。
- 同一問題的不同型別數值不可互換:在 Noul 上校準好的 0.35 門檻不能搬到 Choice 上,門檻要綁定問題型別與模型版本。
繁體中文的額外成本
官方 Models 頁面明說 Jev 的主要訓練語言是英文,準確度在英文最好;CJK 文字包含繁體中文可以處理但目前準確度較低,建議在自己的內容上先測試,並在路由時特別注意 confidence。
對台灣團隊來說,這是導入這個架構的第一個工程決策點,而不是文件末尾的小字。可行的做法有三種,成本與風險依序遞增:
- 問題用英文、內容保持原文:
instructions全部英文撰寫,state 內的段落維持繁體中文原文。先量這個組合的召回率。 - 雙語驗證:同一批資料跑中文 instructions 與英文 instructions,比較兩者的準確率與 confidence 分布,選誤判成本較低的一組。
- 保留門檻放寬:若中文召回率明顯較低,把
KEEP_T調低換取召回,代價是壓縮率下降、成本節省變少。
不要用官方英文範例的門檻直接上線中文流程。
導入前的四步驗證
步驟 1:建立可判對錯的任務集
準備 50 到 100 個有已知正確答案的任務,且答案必須依賴上下文中的特定段落。沒有這組資料,就無法區分「壓縮壞了」與「模型本來就答不出來」。
步驟 2:量召回率,不是量壓縮率
主要指標是「壓縮後仍能答對的比例」,壓縮率只是次要指標。把壓縮後答錯的案例逐一回查 audit,確認是被丟掉、被注入干擾,還是切段切壞了。切段錯誤在實務上比模型誤判更常見。
步驟 3:算整條工作流的成本
把 Jev 呼叫費用、你自己的切段與檢索成本、以及壓縮失誤導致的重試次數一起算。只比單價會高估節省幅度。成本結構的拆法可參考台灣企業導入 AI Agent:真正要算的不是 token,而是工作流成本。
步驟 4:預設保留,不確定就留著
上線時把「低 confidence 一律保留」設成預設行為,並保留一個關閉壓縮的開關。壓縮的失敗成本不對稱:多留一段只是多花一點 token,漏掉一段是答錯。
結論:壓縮該是可稽核的取捨,不是不可追查的改寫
用 Jev 做上下文壓縮的價值不只在便宜。它把壓縮從「請模型改寫」變成「請模型打分、由程式取捨」,留下的是原文,丟掉的有紀錄,而且順手把疑似注入的段落擋在回答模型之外。
代價同樣明確:切段與合併的工程責任回到你身上、繁體中文需要額外驗證、門檻常數要綁定問題型別與模型版本維護。先用一組有正確答案的任務量出召回率,再決定要不要把它接上正式流程。需要協助設計這組驗證資料時,可聯絡優創智能。
來源與查閱日期
- Sac(@Saccc_c),Jev 四大應用場景貼文,2026-09-18。X 貼文
- TypeSafe Docs,〈Models〉(價格、context 上限、語言支援),查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Line-by-line search〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Classifying RAG passages〉,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈Jev 1.13 jaggedness〉,最後檢閱 2026-09-17,查閱 2026-09-18。官方文件
- TypeSafe Docs,〈State〉,查閱 2026-09-18。官方文件
相關推薦與延伸閱讀
- Jev 當 Coding Agent 的判斷層:為什麼 Codex 的操作決策該外包給 System One:Jev 官方定價為每百萬 input token 0.042 美元、output token 免費。本文說明如何把 coding agent 的操作判斷(該用哪
- Jev 是什麼?TypeSafe System One 模型如何讓 AI 成為企業決策函式:Jev 是 TypeSafe 的第一個 System One model。本文拆解 typed questions、機率與 confidence 的差異,並說明
- Devin 自建 Mac 雲端支援 iOS 開發:AI 代理進入原生生態的關鍵條件:Cognition 為 Devin Cloud 加入原生 macOS 虛擬化與 Xcode 模擬器支援。本文從底層虛擬化、TCC 權限治理、預熱機制到企業 iO