文/Laban(優創智能 AI 導入工程師)
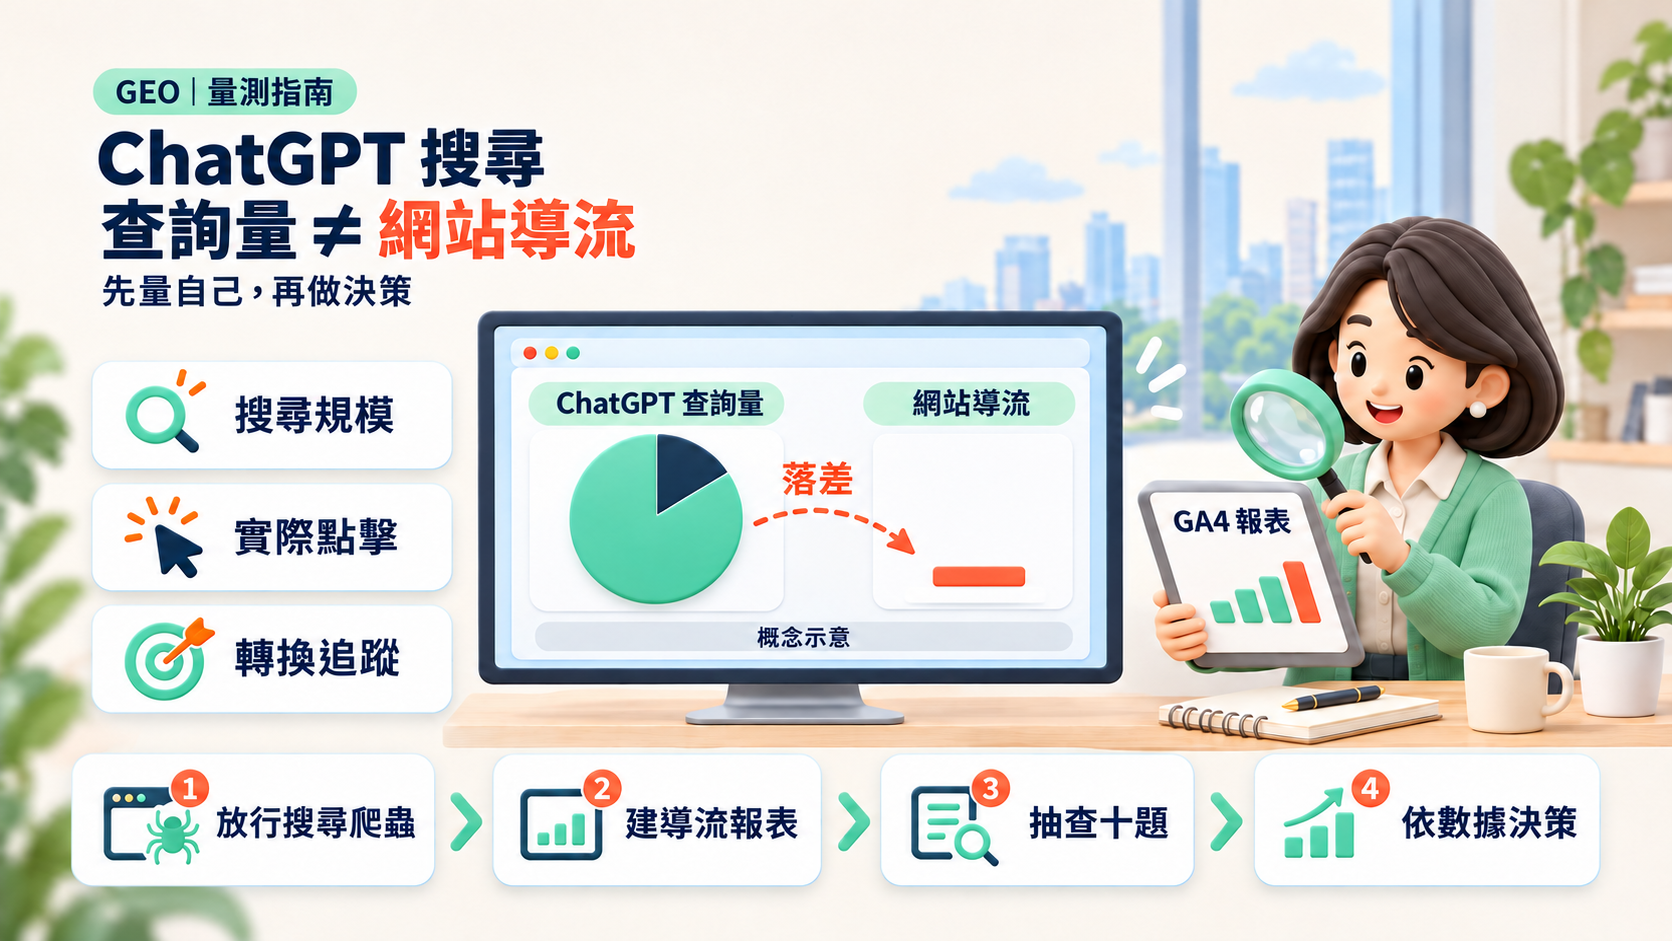
「ChatGPT 搜尋量約 Google 五分之一」是 OpenAI 在 2026 年 11 月 3 日提出的自家估計,指的是會觸發網路搜尋的提問數量,不是市占率,也不是導流量。結論先講:這個數字說明使用者在 ChatGPT 裡找答案的行為已經很普遍,但不代表你的網站會因此多出五分之一的流量。查詢量與導流是兩個數字,企業要量的是後者,以及答案裡有沒有正確提到你。
本文分成三部分:來源中的已知事實、我們在導入現場的編輯分析,以及台灣企業本週就能做的四個步驟。本文不是流量預測,也不推估台灣市場的比例;文中沒有任何台灣專屬數據,因為來源裡沒有。
一、已知事實:OpenAI 說了什麼,第三方怎麼看
1. OpenAI 的說法
據 Big Technology(Alex Kantrowitz,2026-11-03)報導,ChatGPT 消費者產品負責人 Adam Fry 在 OpenAI 於紐約舉辦的晚宴對談中表示,ChatGPT 的搜尋型查詢量「現在大約是 Google 查詢量的五分之一」。同篇報導也寫到,OpenAI 表示 ChatGPT 每週活躍使用者在 60 天內從 10 億成長到 12 億。
什麼算「搜尋」?Search Engine Journal(Matt G. Southern,2026-11-03)引述 Fry 的定義:每次提出問題、ChatGPT 去網路上查,就算一次搜尋。
2. 這個數字沒有交代的部分
Search Engine Journal 指出三個缺口:Fry 沒有說明比較用的是哪一個 Google 查詢量數字,也沒有說明統計期間與涵蓋地區。同篇也提到,Ahrefs 在 2 月曾估出約 12% 的比例,但那是依提問類型分類,定義不同,兩個數字不能直接比較。Channel Insider(2026-11-04)同樣寫明,這是 OpenAI 提供的說法,報導中沒有計算方法。
3. 導流的數字差很多
Search Engine Journal 引用 Ahrefs 流量追蹤(2026-11-03 更新):十月在 118,671 個網站中,Google 占追蹤流量的 24.74%,ChatGPT 占 0.36%。Android Headlines(2026-11-04)也引用同一組數字對照 OpenAI 的說法。Search Engine Journal 的收尾提醒是:之後任何引用 ChatGPT 搜尋數據的報告,都應該分開定義「查詢量」與「導流量」。
4. OpenAI 官方文件的兩條規則
- OpenAI 爬蟲文件:OAI-SearchBot 用來讓網站出現在 ChatGPT 的搜尋功能;選擇退出 OAI-SearchBot 的網站不會出現在 ChatGPT 搜尋答案中。GPTBot 管的是模型訓練,與搜尋分開。robots.txt 更新後,搜尋結果約需 24 小時才會調整。
- OpenAI 說明中心〈Publishers and Developers FAQ〉:ChatGPT 會在搜尋結果的導流網址自動加上
utm_source=chatgpt.com,方便追蹤與分析來自 ChatGPT 搜尋的流量。
二、編輯分析:對台灣企業的三個意義
1. 「被拿去回答」和「被點進來」是兩件事
五分之一與 0.36% 不矛盾,它們量的是不同東西。前者是使用者在 ChatGPT 裡問了多少需要上網查的問題,後者是有多少人從 ChatGPT 點進網站。中間差的那一段,是使用者在對話裡直接拿到答案、沒有點擊。對企業來說,AI 搜尋的價值不只在點擊,也在答案裡有沒有正確提到你;但只有點擊與轉換,才進得了你的營收報表。這兩件事要分開量,不能用一個「AI 能見度分數」混在一起。我們在 GEO 量測框架一文把它拆成可抓取、可理解、被引用、帶來轉換四段,這次的新聞剛好說明了為什麼不能跳過中間兩段。
2. 不要拿全球數字當自己的預算依據
這次的數字都不是台灣資料:OpenAI 沒有公布地區,Ahrefs 的樣本是它追蹤的網站。台灣企業的產業、客群與搜尋習慣差很多,B2B 設備商與餐廳的情況不會一樣。決定 GEO 投入多少,看的是你自己網站上 chatgpt.com 工作階段的數量與轉換,不是新聞標題的比例。我們在 Reddit 搜尋流量下滑一文談過同一個原則:外部趨勢是警訊,預算要用自家數字決定。
3. 最便宜的損失,是自己把搜尋爬蟲擋掉
很多網站為了不讓內容被拿去訓練,在 robots.txt 或 WAF 裡一併擋掉所有 OpenAI 的爬蟲,結果連 ChatGPT 搜尋也看不到。依 OpenAI 文件,訓練與搜尋是兩個不同的爬蟲,可以分開設定。這個檢查不用花錢,卻常被漏掉;AI 爬蟲存取治理一文整理過 robots.txt 與防火牆規則要一起看的理由,ChatGPT 代理網站封鎖一文則談到代理端可達性的另一層問題。
三、四個步驟:本週就能開始做
步驟 1:確認 OAI-SearchBot 沒有被擋
打開網站的 /robots.txt,確認沒有對 OAI-SearchBot 或 User-agent: * 設下會擋住重要頁面的 Disallow。如果你想拒絕模型訓練,只針對 GPTBot 設定即可。接著到 WAF 或 CDN 的機器人管理規則,確認沒有把 OpenAI 的搜尋爬蟲列入封鎖。改完後至少等 24 小時再測試。
步驟 2:在 GA4 建一張 ChatGPT 導流報表
在 GA4 的流量開發報表中,以「工作階段來源」篩選 chatgpt.com,記錄最近 90 天的工作階段數、到達頁面與關鍵事件(電話點擊、表單送出、預約完成)。這就是你的基準線。之後每月同一天記錄一次,看的是自己的趨勢,不是跟新聞比例比。
步驟 3:每月抽查 10 個客戶會問的問題
列出 10 個客戶實際會問、而且你的網站有答案的問題(例如「台中 XX 維修推薦」「XX 設備保固怎麼算」)。每月在 ChatGPT 問一次,記錄四欄:有沒有提到你、資訊是否正確、有沒有附上你的網址、引用的是哪一頁。這張表量的是「被拿去回答」,與步驟 2 的「被點進來」分開記錄。
步驟 4:依兩張表決定下一步
三個月後並排看兩張表,判斷落在哪一格:
| 抽查結果 | GA4 導流 | 建議 |
|---|---|---|
| 常被提到、資訊正確 | 有轉換 | 維持現狀,把有轉換的到達頁當範本擴充 |
| 常被提到、資訊正確 | 幾乎沒有 | 檢查答案是否附上網址,強化頁面上值得點進來的內容(報價試算、預約、規格表) |
| 很少被提到或資訊錯誤 | 任何情況 | 先修可抓取與內容正確性,再談導流 |
驗收標準:三個月後你應能回答三個問題——OAI-SearchBot 能否抓到你的重要頁面;ChatGPT 每月帶來多少工作階段與轉換;客戶常問的問題中,ChatGPT 有幾題正確提到你。三題都有數字,才有資格決定 GEO 要加碼、維持還是暫緩。
四、結語:先量自己,再看標題
「五分之一」會被很多人拿來說明 AI 搜尋很重要,這個方向沒錯,但它說的是使用者行為,不是你的生意。真正該做的是把查詢量與導流分開,用自己網站的數字建立基準線。數字出來之後,要不要投入、投入多少,就不再是憑感覺。
如果你想先檢查網站對 AI 搜尋爬蟲的開放設定,或建立第一張 ChatGPT 導流與引用抽查表,歡迎與我們聯繫。
免責說明:本文整理自 2026 年 11 月 3 日至 4 日的公開報導與 OpenAI 官方文件,數字均依來源原文,不代表優創智能對市場規模或任何網站流量的預測。OpenAI 的查詢量比例為該公司自行估計,未公開計算方法;平台設定與文件內容可能隨時變更,實作前請以官方最新文件為準。
參考來源
- Big Technology(Alex Kantrowitz),〈OpenAI: ChatGPT Search Is About 20% of Google's, 250 Million People Speak With ChatGPT, and Chat Is Merging With Work〉,2026-11-03:https://www.bigtechnology.com/p/openai-chatgpt-search-is-about-20
- Search Engine Journal(Matt G. Southern),OpenAI 搜尋量說法與 Ahrefs 導流數據報導,2026-11-03:https://www.searchenginejournal.com/googles-search-volume-is-about-5x-chatgpts-openai-says/595817/
- Channel Insider(Liz Ticong),〈OpenAI Says ChatGPT Search Activity Nears 20% of Google's〉,2026-11-04:https://www.channelinsider.com/ai/news-chatgpt-search-volume-20-percent-google/
- Android Headlines(Jean Leon),〈ChatGPT Already Handles 20% of Google Search Volume After Massive User Growth〉,2026-11-04:https://www.androidheadlines.com/2026/11/chatgpt-hits-20-percent-google-search-volume.html
- OpenAI,開發者文件〈Bots〉(OpenAI 爬蟲說明),查閱日 2026-11-05:https://developers.openai.com/api/docs/bots
- OpenAI 說明中心,〈Publishers and Developers FAQ〉,查閱日 2026-11-05:https://help.openai.com/en/articles/12627856-publishers-and-developers-faq
相關推薦與延伸閱讀
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試
- AI 回答引用誰?Muck Rack 十月報告:逾八成四來自第三方,品牌自有內容只占 15.2%,台灣企業 GEO 該補的外部來源:GEO 不能只改官網:Muck Rack 於 2026 年 10 月 28 日發表的報告指出,AI 回答的引用超過 84% 來自媒體與第三方來源,品牌自有內容只
- AI crawler 存取治理:用 robots.txt、WAF 與日誌驗證 GEO 可見性:以 robots.txt、WAF 與日誌排查特定爬蟲的存取問題,分清模擬請求、已驗證來源及實際 AI 引用;技術通過不等於被採用。本文先把三種控制分開,用請求路