文/Laban(優創智能 AI 導入工程師)
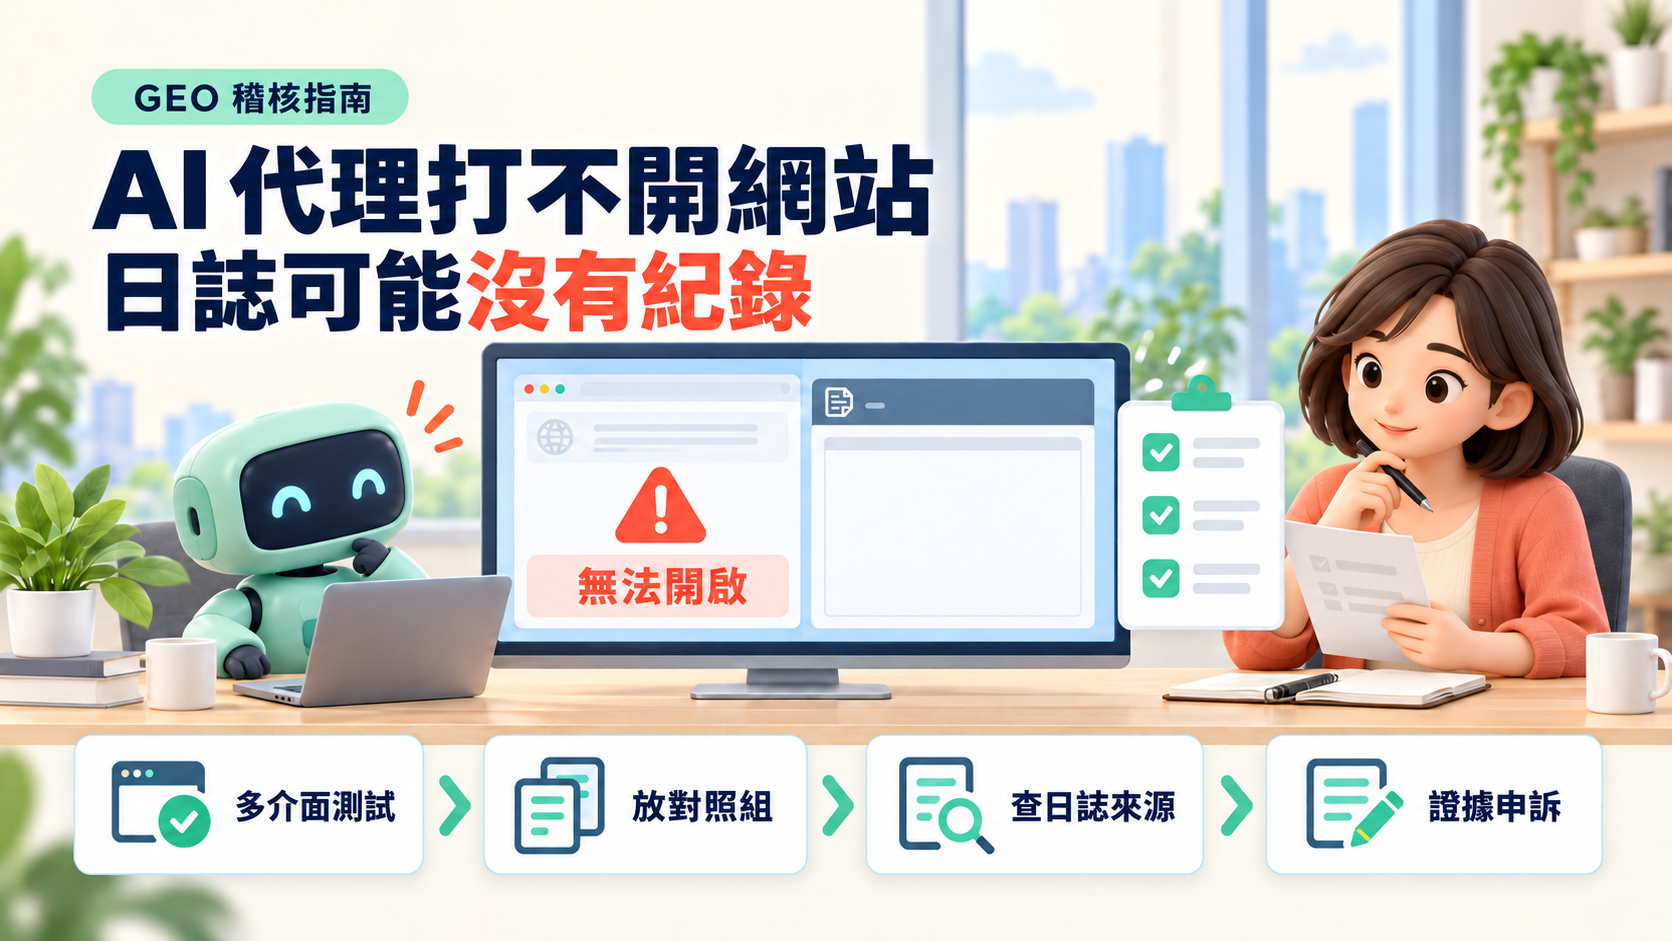
代理可達性,是指 ChatGPT、Codex 這類 AI 代理在使用者要求時,能不能真的打開你的網頁。結論先講:robots.txt 開放只代表你沒擋 OpenAI,不代表 OpenAI 沒擋你。 Search Engine Journal 在 2026 年 10 月 29 日揭露,OpenAI 的瀏覽工具在開頁前會先查一個網站安全分級;被擋的網站不會在自己的日誌看到任何紀錄。所以 GEO 稽核除了看「有沒有被引用」,還要多驗一項:「代理打不打得開」。
本文是新聞解析與檢查清單,不是 OpenAI 的官方說明,也不代表優創智能與 OpenAI 有合作。目前公開資料大多來自一位作者的個案觀察與用戶回報,OpenAI 尚未公開說明這套機制;我們會把已知事實、作者推測與我們的建議分開寫。
一、已知事實:目前查得到什麼?
1. Search Engine Journal 記錄的個案(2026-10-29)
Search Engine Journal 的 Dan Taylor 在 2026 年 10 月 29 日發表文章,描述他協助的一家國際媒體網站:
- 網站的 robots.txt 對 OpenAI 開放,但從 2026 年 5 月起,ChatGPT 載入不了它的頁面,伺服器日誌也沒有 ChatGPT 的流量。
- Codex Browser Use 拒絕造訪,並引用網站安全政策,錯誤訊息是「Browser use is not permitted on [網域]」。
- 同一個 session 裡,兩個競爭對手網站可以正常載入;在 Chrome 對該品牌設「Always allow」也沒用。
- 數週後再測,主站、子網域與文章頁共 5 個網址仍然全部被擋。
- OpenAI 客服將案件往內部升級,回覆團隊需要「review the block and determine whether it's expected」,並確認有安全封鎖,但沒有說明原因。
作者把這套內部網站安全分級稱為 Aura(OpenAI 未證實這個名稱)。依他的觀察,用戶端會呼叫一個網站狀態查詢端點;封鎖判定會在本機快取 24 小時;查詢時若發生網路錯誤會預設放行,但明確的封鎖判定很嚴格,企業管理員設的允許規則也無法覆蓋。
2. GitHub 上的用戶回報
在 OpenAI 的 Codex 開源專案上,至少有兩則相關議題:
| 議題 | 開立日期 | 回報內容 |
|---|---|---|
| #29343 | 2026-06-21 | Chrome 外掛、Browser Use 與 Computer Use 拒絕操作特定網站,回報的網域包括 1688.com、taobao.com、aliexpress.com、pinduoduo.com、mega.nz、vk.com、civitai.com 等;用戶回報持續到 2026-10-23 |
| #45346 | 2026-09-14 | macOS 上 1688.com 被網站安全政策擋下,錯誤訊息為「The site-safety policy blocks this action; no user permission prompt or Auto-review was attempted.」,之後也有 Windows 用戶回報相同情況 |
兩則議題在本文查閱時(2026-10-31)都仍是開啟狀態,我們查閱的討論內容中未見 OpenAI 人員回覆。#45346 有一位用戶留言指出 Browser Use 會呼叫 chatgpt.com/backend-api/aura/site_status 並在失敗時拒絕,這是第三方觀察,不是 OpenAI 的說明。
3. OpenAI 官方文件寫了什麼?
OpenAI 的爬蟲文件(2026-10-31 查閱)把幾個 user agent 分開管理:OAI-SearchBot 用於 ChatGPT 搜尋結果、GPTBot 與模型訓練有關、ChatGPT-User 處理使用者發起的動作。文件寫明 ChatGPT-User「robots.txt rules may not apply」,因為那是使用者發起的請求。我們查閱時未見該文件提到網站安全分級。
Search Engine Journal 引述 OpenAI 說明中心的內容,指代理可能因安全、資安或法規原因被全域封鎖清單擋下,與非法活動相關的網站也會被擋。我們無法直接讀取該說明頁,這段以 SEJ 轉述為準。
二、編輯分析:這對台灣企業代表什麼?
1. 不要先假設自己被擋,但要能證明沒有
GitHub 回報的網域多半是中國電商、通訊與檔案分享平台,以及少數特定網站;SEJ 的個案是一家正常經營的媒體。目前沒有證據顯示台灣企業網站普遍受影響。 我們的判斷是:這件事該做的不是恐慌,而是把「代理打不打得開」變成例行檢查的一項,因為一旦發生,你自己的分析工具看不出來。
2. 「沒被引用」的原因多了一層
我們在 SEO 第一頁卻沒被 AI 引用 談過內容與結構的原因。這次的資訊提醒的是另一層:問題可能不在內容,而在代理根本打不開頁面。 SEJ 也指出,被擋的網站可能被代理略過,改去看可以開的競爭對手或次要來源。如果 AI 一直用論壇或舊文章描述你的產品,可達性值得先排除。
3. 跨境採購團隊要注意工具限制
如果你的採購或營運團隊用 Codex、ChatGPT 的瀏覽功能查 1688、淘寶等平台,GitHub 的回報顯示這些網域可能被擋。這不是你的設定問題,流程上要保留人工或其他工具的替代做法,不要把這類網站的查價寫進只靠單一代理的自動化流程。
4. SEJ 作者對原因的推測
SEJ 作者推測,狀態查詢會連同對話細節一起送出,某些對話內容可能觸發整站封鎖。這是作者推測,文章本身也標明未經證實,不要當成已知原因。
三、六個步驟:把代理可達性加進 GEO 稽核
以下整理自 SEJ 文章的診斷建議,改寫成台灣企業官網負責人可以照做的流程。
步驟 1:在不同介面測同一組網址
挑首頁、主要服務頁、一篇文章頁與子網域,在 ChatGPT 的即時搜尋、ChatGPT 瀏覽與 Codex Browser Use(如果團隊有用)各測一次,請它開啟並摘要頁面。逐一記下是否成功與完整錯誤訊息。
步驟 2:同一個 session 放對照組
在同一次測試裡加入兩、三個同業或大型網站。對照組開得了、你的開不了,才值得往下查;全部都開不了,多半是服務本身異常。
步驟 3:查 CDN 與伺服器日誌,判斷是哪一端擋的
對照測試時間查 CDN、WAF 與伺服器日誌。有 403、驗證挑戰頁或防火牆事件,是你這端擋的;完全沒有紀錄,才可能是 OpenAI 端擋的。也順便看 OAI-SearchBot、GPTBot、ChatGPT-User 最近有沒有成功造訪。用 Cloudflare 的網站,記得一併檢查 AI 爬蟲與 bot 管理設定,相關做法可參考 llms.txt 與 Markdown 內容協商。
步驟 4:排除自己的設定
確認 robots.txt、WAF 規則、地區封鎖與速率限制沒有誤擋。SEJ 特別提醒先排除自己這端,再往外找原因。
步驟 5:整理證據並開客服案件
如果確認是 OpenAI 端擋的,把截圖、對照組結果、日誌片段、爬蟲造訪數據與 robots.txt 整理成一份證據,開 OpenAI 客服案件並保留案件編號。SEJ 建議問三個問題:這個網域有沒有網站安全分級、原因是什麼;影響哪些介面;審查流程是什麼。不要用工具繞過封鎖,SEJ 提醒那可能違反規範,也會削弱申訴。
步驟 6:排進例行檢查,定期重測
把步驟 1 到 3 變成每月一次的固定項目,記錄日期、時區、結果。網站改版、換 CDN 或調整防火牆之後,加測一次。
驗收標準:做完六步,你要能回答三個問題:ChatGPT 與 Codex 目前打不打得開你的主要頁面;如果打不開,是你這端還是 OpenAI 端擋的;下一次檢查是哪一天、誰負責。三題答得出來,代理可達性才算在你的掌控之中。
四、結語:看不到的流失,才要主動去量
這次的資訊大多來自個案與用戶回報,OpenAI 還沒有公開說明;依 SEJ 的觀察,也沒有像搜尋引擎站長工具那樣的查詢或申訴介面。AI 代理成為客戶找資料的入口之後,「打不打得開」和「有沒有被引用」一樣需要被量測。 先確認自己沒被擋,再談內容優化。
如果你想知道自己的網站在 AI 搜尋與代理眼中長什麼樣子,歡迎與我們聯繫,我們可以從一次 GEO 健檢開始。
免責說明:本文依據 Search Engine Journal 文章、openai/codex GitHub 議題與 OpenAI 爬蟲文件整理,資料截至 2026 年 10 月 31 日。網站安全分級的名稱、運作方式與觸發原因來自第三方觀察,OpenAI 尚未公開證實;OpenAI 說明中心的內容為 SEJ 轉述,本文未能直接查閱。文中步驟為一般性建議,不保證特定成效。
參考來源
- Search Engine Journal(Dan Taylor),〈OpenAI's Agents Can Silently Block Your Site – & Your Logs Won't Show It〉,2026-10-29:https://www.searchenginejournal.com/openais-aura-safety-check-can-block-your-site-from-chatgpt-browsing/594322/
- GitHub openai/codex Issue #29343,〈Chrome plugin, browser and computer use refuse to interact with certain sites.〉,2026-06-21 開立,2026-10-31 查閱:https://github.com/openai/codex/issues/29343
- GitHub openai/codex Issue #45346,〈[macOS][Browser Use] 1688.com blocked by site-safety policy without a permission or recovery prompt〉,2026-09-14 開立,2026-10-31 查閱:https://github.com/openai/codex/issues/45346
- OpenAI Developers,OpenAI 爬蟲與使用者代理說明文件,2026-10-31 查閱:https://developers.openai.com/api/docs/bots
相關推薦與延伸閱讀
- AI Agent 可讀性與 GEO:把可讀性變成可測試的內容契約:建立 AI agent 可讀性的驗收方法:分開檢查 HTTP 內容、瀏覽器操作、資料一致性及實際引用,避免把技術檢查通過誤當成引擎採用證據。本文先定義四個可測試
- AI 回答引用誰?Muck Rack 十月報告:逾八成四來自第三方,品牌自有內容只占 15.2%,台灣企業 GEO 該補的外部來源:GEO 不能只改官網:Muck Rack 於 2026 年 10 月 28 日發表的報告指出,AI 回答的引用超過 84% 來自媒體與第三方來源,品牌自有內容只
- AI crawler 存取治理:用 robots.txt、WAF 與日誌驗證 GEO 可見性:以 robots.txt、WAF 與日誌排查特定爬蟲的存取問題,分清模擬請求、已驗證來源及實際 AI 引用;技術通過不等於被採用。本文先把三種控制分開,用請求路
- Google 開放 Connected Apps Platform:用 MCP 把服務接進 Gemini 與 Search,GEO 從被引用走向被呼叫:Google 於 2026 年 10 月 28 日推出 Connected Apps Platform 預覽,企業可用 MCP 把服務接進 Gemini 與 S
- Microsoft Clarity 開始追蹤 AI 代理:免費看代理怎麼逛你的網站,台灣企業該先設定的五件事:用免費的 Microsoft Clarity 就能看到 AI 代理怎麼逛你的網站,但目前只認得 Google、OpenAI 與 Anthropic 的代理。微軟